Un fallo de red interrumpió durante más de un día el acceso a Outlook, Teams, Copilot y otras funciones de Microsoft 365 para usuarios en distintas regiones del mundo. Microsoft indicó que el problema surgió tras un cambio de red e informó de avances en la recuperación, pero al 14 de noviembre la página de estado seguía registrando degradación del servicio. La compañía descartó, según sus propias declaraciones, un ataque informático y cualquier relación con sistemas de inteligencia artificial: el análisis técnico completo llegará con el informe post incidente.
Para elaborar este artículo se consultaron la página pública de estado de Microsoft, las actualizaciones de Associated Press y el resumen de Sky News. Según AP, los reportes en Downdetector alcanzaron niveles muy superiores a la media en 74 países; se trata de notificaciones enviadas por usuarios, no de un recuento oficial de afectados.
El fallo afectó al correo, la colaboración y Copilot
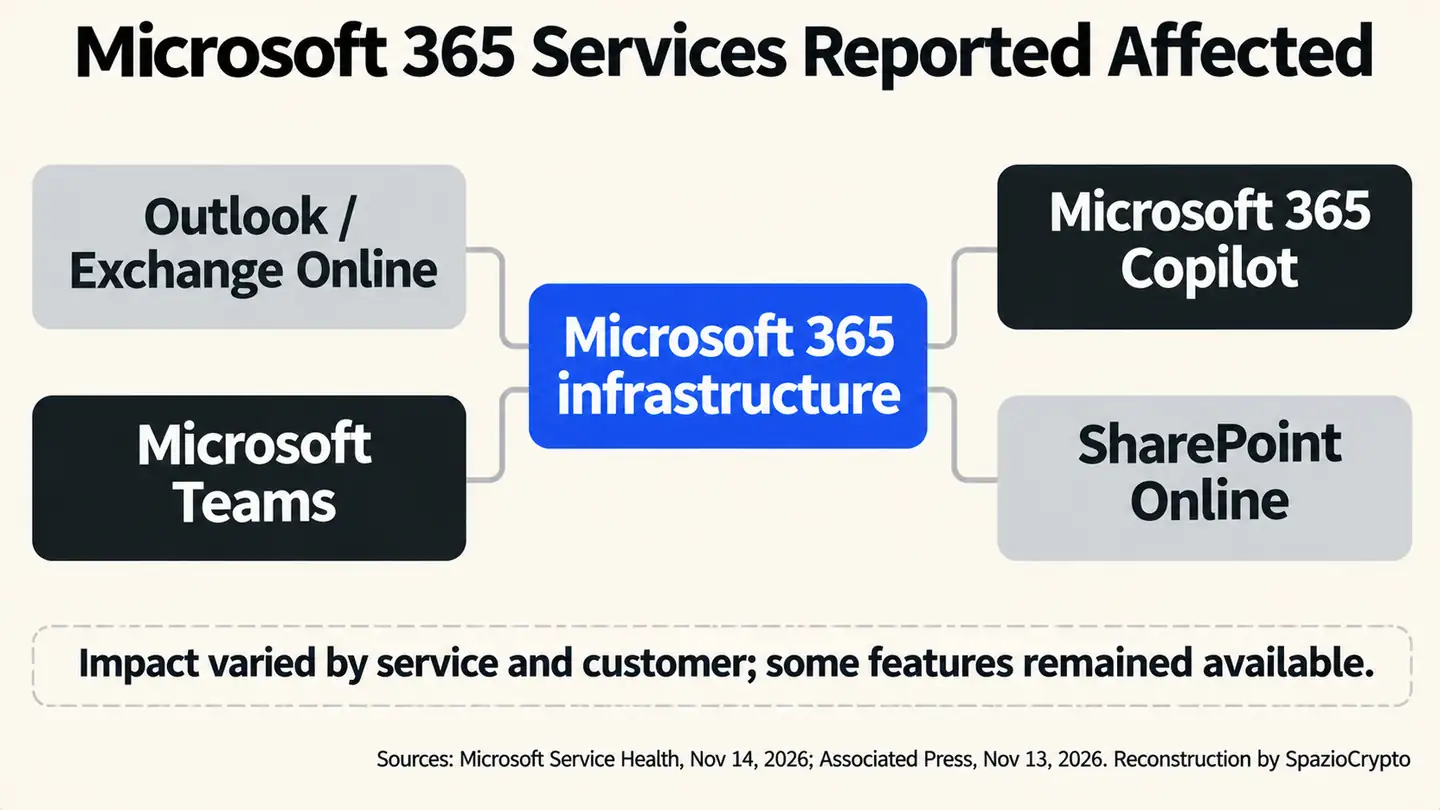
El incidente comenzó el 12 de noviembre y afectó a varios componentes de Microsoft 365. Entre los servicios mencionados en las actualizaciones figuran Exchange Online y Outlook, Teams, Copilot, SharePoint y algunas funciones de administración y productividad. El impacto no fue idéntico para cada producto: Microsoft indicó que las funciones dependientes del correo y Exchange podían estar degradadas, mientras que algunas capacidades no vinculadas a esos sistemas seguían disponibles.
Los problemas reportados por los usuarios incluían dificultades para acceder al buzón, retrasos en la entrega de correos e interrupciones en funciones de colaboración y asistencia de IA. La página de estado de Microsoft señalaba que algunos clientes podían seguir experimentando accesos intermitentes o recibir mensajes con demora mientras continuaban las tareas de recuperación.
La propagación entre productos distintos es el rasgo más llamativo del episodio. Un servicio en la nube no está compuesto por aplicaciones independientes: autenticación, red, correo, almacenamiento y servicios de backend pueden sustentar varias herramientas al mismo tiempo. Cuando una capa compartida pierde capacidad o no responde correctamente, el efecto puede aparecer en productos que para los usuarios parecen separados.
Esto no significa que todos los servicios de Microsoft hayan estado caídos ni que Azure haya sufrido una interrupción generalizada. El corte documentado afectó a funciones específicas de Microsoft 365, con impactos distintos por región y producto. La sección de SpazioCrypto dedicada a los data centers recoge noticias sobre las infraestructuras que sostienen los servicios en la nube y la IA.
Microsoft vincula el fallo a un cambio de red
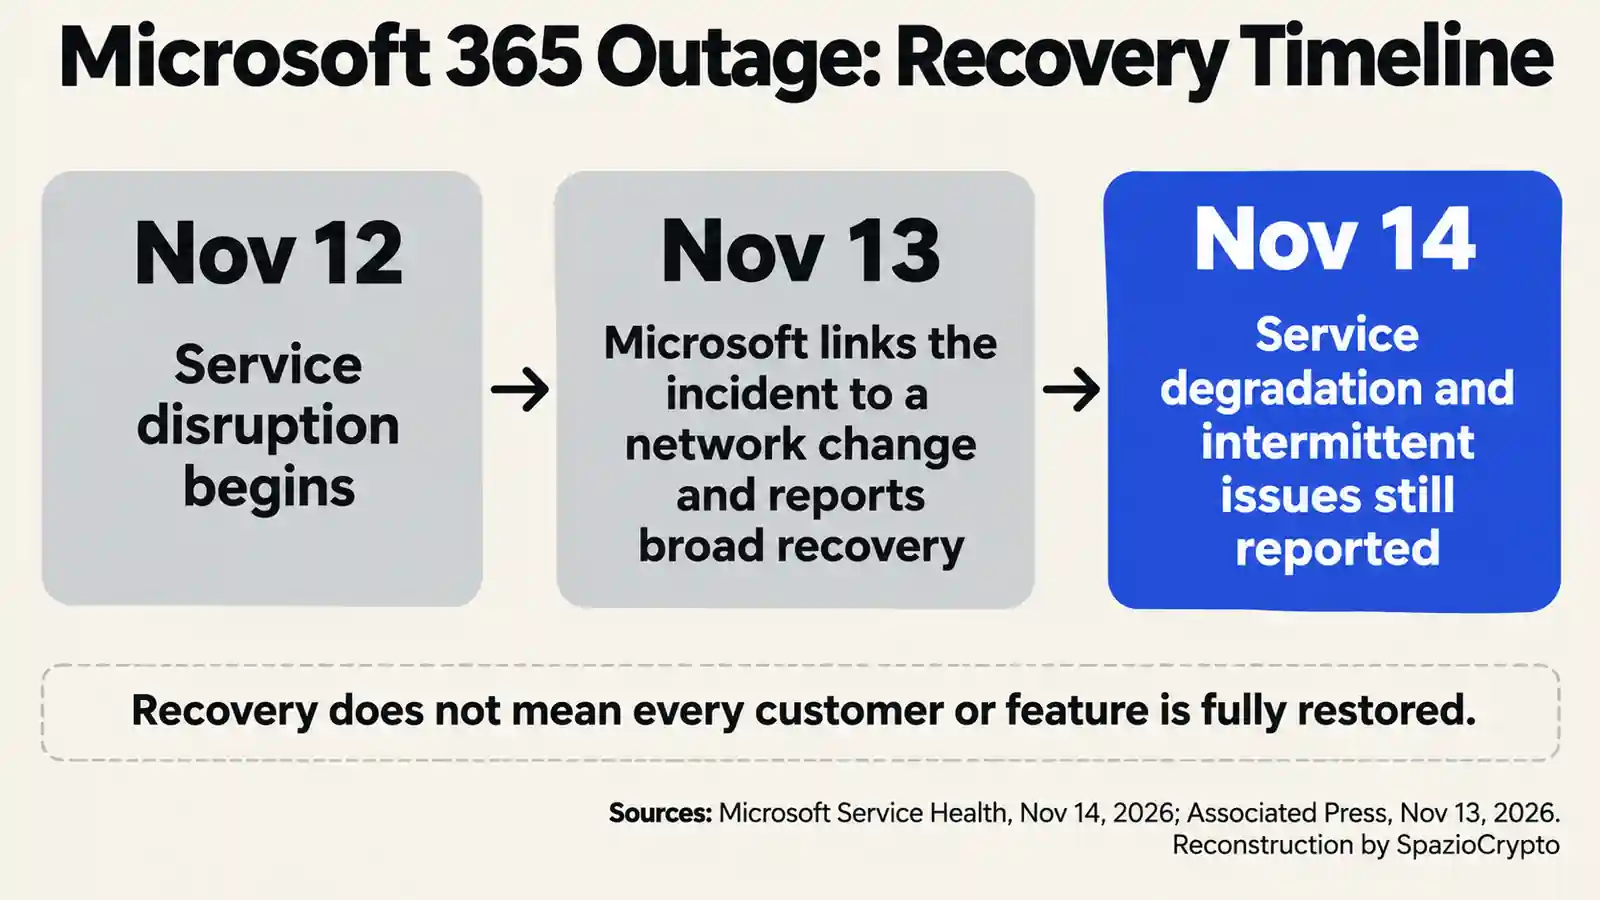
En la actualización del 13 de noviembre, Microsoft describió el incidente como un problema técnico sin relación con un ciberataque ni con la IA o los agentes. La compañía indicó que un problema ocurrido durante una actualización previa de capacidad de red se manifestó tras un cambio posterior. Los ingenieros trabajaron para recuperar capacidad, restaurar los sistemas afectados y devolver gradualmente los servicios a niveles estables.
La comunicación pública aclara el tipo de evento, pero no equivale todavía a un análisis técnico completo de la causa. Microsoft anunció que publicará un informe post incidente tras la mitigación, con la causa raíz y las medidas de prevención. Hasta ese momento, los detalles más específicos sobre configuraciones, componentes involucrados y secuencia de errores no deben presentarse como confirmados.
La exclusión de un ciberataque también hay que atribuirla a la empresa. Microsoft declaró no tener evidencias de actividad maliciosa asociada al problema; se trata de una actualización útil, pero no sustituye al informe final ni a una verificación independiente. Las primeras hipótesis que circularon en internet no constituyen pruebas sobre el origen del fallo.
La distinción entre un problema técnico y un incidente de seguridad es relevante tanto para los usuarios como para las organizaciones. En el primer caso el riesgo principal es la disponibilidad; en el segundo pueden añadirse acceso no autorizado o exposición de datos. Por ahora, la información pública de Microsoft apunta a un problema de disponibilidad y capacidad, no a una vulneración de datos.
La recuperación es amplia, pero el incidente no está cerrado
Según AP, el 13 de noviembre Microsoft observaba una recuperación extendida y mayor estabilidad en Norteamérica, Europa y Asia-Pacífico. Las colas de correo volvían hacia niveles normales, aunque algunos clientes podían seguir sufriendo accesos intermitentes y retrasos. El 14 de noviembre la página pública de estado seguía reportando degradación de Microsoft 365, por lo que la recuperación no debe confundirse con el cierre formal del incidente.
Las consecuencias operativas superaron el simple inconveniente individual. AP recogió reportes de interrupciones en empresas y organismos públicos de varios países, incluyendo actividades que dependen del correo para comunicaciones y procedimientos. Las repercusiones varían de una organización a otra: no todas las funciones estaban detenidas y no todos los entes citados reportaron una interrupción crítica.
Microsoft 365 cuenta con más de 450 millones de suscripciones comerciales de pago, según AP. El dato ayuda a comprender la escala potencial de un fallo de la plataforma, pero no indica cuántos usuarios resultaron efectivamente afectados en esta ocasión. La compañía no publicó un total verificado de cuentas afectadas.
El episodio devuelve al primer plano la dependencia de las empresas respecto a unos pocos proveedores de nube y herramientas de productividad. Las autoridades europeas ya han llamado la atención sobre los riesgos asociados a la concentración de servicios digitales y de IA en operadores externos a la Unión, como se analiza en el artículo sobre la dependencia de las finanzas europeas de infraestructuras digitales extranjeras. Este incidente no demuestra por sí solo un riesgo sistémico, pero muestra por qué los planes de continuidad y los sistemas alternativos merecen verificaciones prácticas.
La resiliencia depende también de los planes de continuidad
Una organización no puede evitar todos los fallos de un proveedor externo, pero sí puede reducir el impacto operativo. Entre las medidas que conviene revisar están los procedimientos alternativos para comunicaciones urgentes, copias accesibles de los contactos esenciales, exportación y almacenamiento independiente de los datos, roles de emergencia y modalidades para retomar el trabajo cuando la plataforma vuelva a estar disponible. No basta con tener un plan escrito: debe probarse sin depender de los mismos servicios que podrían estar caídos.
El tema también afecta a la estructura física de la economía digital. La expansión de los data centers de Microsoft y otros hyperscalers suele debatirse en términos de energía y capacidad de cómputo; la fiabilidad, la redundancia y las interconexiones son otra parte de esa misma infraestructura. Cuantos más servicios se apoyan en plataformas compartidas, más importante resulta entender qué dependencias son comunes y qué alternativas son realmente independientes.
El crecimiento de los servicios en la nube hace estratégica la capacidad de distribuir cargas y datos en varias infraestructuras. La expansión de IREN hacia los data centers de IA y la carrera global por las infraestructuras de IA muestran cómo la capacidad, la energía y la geografía se están convirtiendo en componentes esenciales de los servicios digitales. La redundancia no se consigue solo comprando más servidores: importa también la separación de los sistemas y la posibilidad real de cambiar a un proveedor alternativo.
La comparación con los acuerdos multi-cloud debe hacerse con precisión. Un segundo proveedor no garantiza continuidad si la identidad, el correo, los backups o los procesos internos siguen ligados al mismo punto de fallo. Incluso el acceso a modelos y servicios desde distintas nubes, como en el caso de la vista previa de modelos de OpenAI en Google Cloud, no equivale automáticamente a una estrategia de recuperación ante desastres: se necesitan arquitecturas y pruebas específicas.
Microsoft 365: resumen del incidente
Microsoft 365: resumen del incidente
Qué está confirmado y qué no
- Confirmado: Microsoft reportó un incidente que afectó a varios servicios de Microsoft 365 y comunicó avances en la recuperación.
- No especificado: el número verificado de usuarios afectados y la causa raíz completa, cuya documentación Microsoft prometió publicar una vez concluida la mitigación.
- Pendiente de seguimiento: el cierre formal del incidente, el informe técnico posterior y el restablecimiento estable del correo y las funciones asociadas.
La lectura más amplia
Desde una perspectiva editorial, este episodio pone de relieve el coste operativo de la concentración tecnológica: un único cambio de red puede propagarse a herramientas distintas cuando comparten componentes e infraestructura común. Esto no prueba que la nube sea intrínsecamente poco fiable, ni demuestra que la redundancia de Microsoft fuera insuficiente. Cualquier juicio sobre causas y medidas correctoras debe esperar al informe técnico oficial.
Las próximas señales a vigilar son el cierre formal del incidente, la explicación detallada de la secuencia técnica y las acciones preventivas que anuncie Microsoft. Para los clientes, la prueba más útil es comprobar si los procedimientos de emergencia propios funcionan cuando el correo, la colaboración y el acceso a archivos dependen al mismo tiempo de un único ecosistema.
Fuentes
Estado de los servicios y actualizaciones sobre la recuperación: Microsoft Service Health, consultado el 14 de noviembre de 2026. Alcance internacional, restablecimiento y dependencia entre servicios: Associated Press, 13 de noviembre de 2026. Declaraciones de Microsoft sobre la causa técnica y la recuperación: Sky News, 13 de noviembre de 2026.