Adobe y NVIDIA ampliaron el 15 de octubre de 2026 su colaboración para acelerar Photoshop, Premiere, Substance 3D, Frame.io y Brand Concierge. Este nuevo capítulo de Adobe y NVIDIA para el creador con IA combina cómputo local sobre RTX Spark con pipelines en la nube para video y búsqueda multimedia. Adobe declara un rendimiento hasta dos veces superior en algunas cargas de trabajo seleccionadas, pero no publica un benchmark único válido para cada proyecto, máquina o función.
Hemos revisado el comunicado de Adobe y la documentación pública de NVIDIA sobre RTX Spark. Los resultados de rendimiento son mediciones de las propias empresas sobre workloads específicos. No encontramos ninguna evaluación independiente que replique el conjunto completo con archivos, versiones de software y condiciones idénticas.
Qué cambia en las herramientas creativas
Photoshop, Premiere y Substance 3D se optimizan para el superchip RTX Spark, que integra memoria y cómputo de IA local. Adobe afirma haber rediseñado partes de Photoshop en torno a la composición acelerada por GPU. En Premiere, la reproducción, el renderizado, los efectos, el color y las funciones de IA como Enhance Speech y Object Mask reciben aceleración RTX.
Esta elección desplaza el foco del generador individual al flujo de trabajo completo. Es el mismo cambio que analizamos en nuestro artículo sobre los agentes de IA para freelancers y pymes: el valor no reside solo en producir un resultado, sino en conectar herramientas, datos y revisiones sin perder el control.
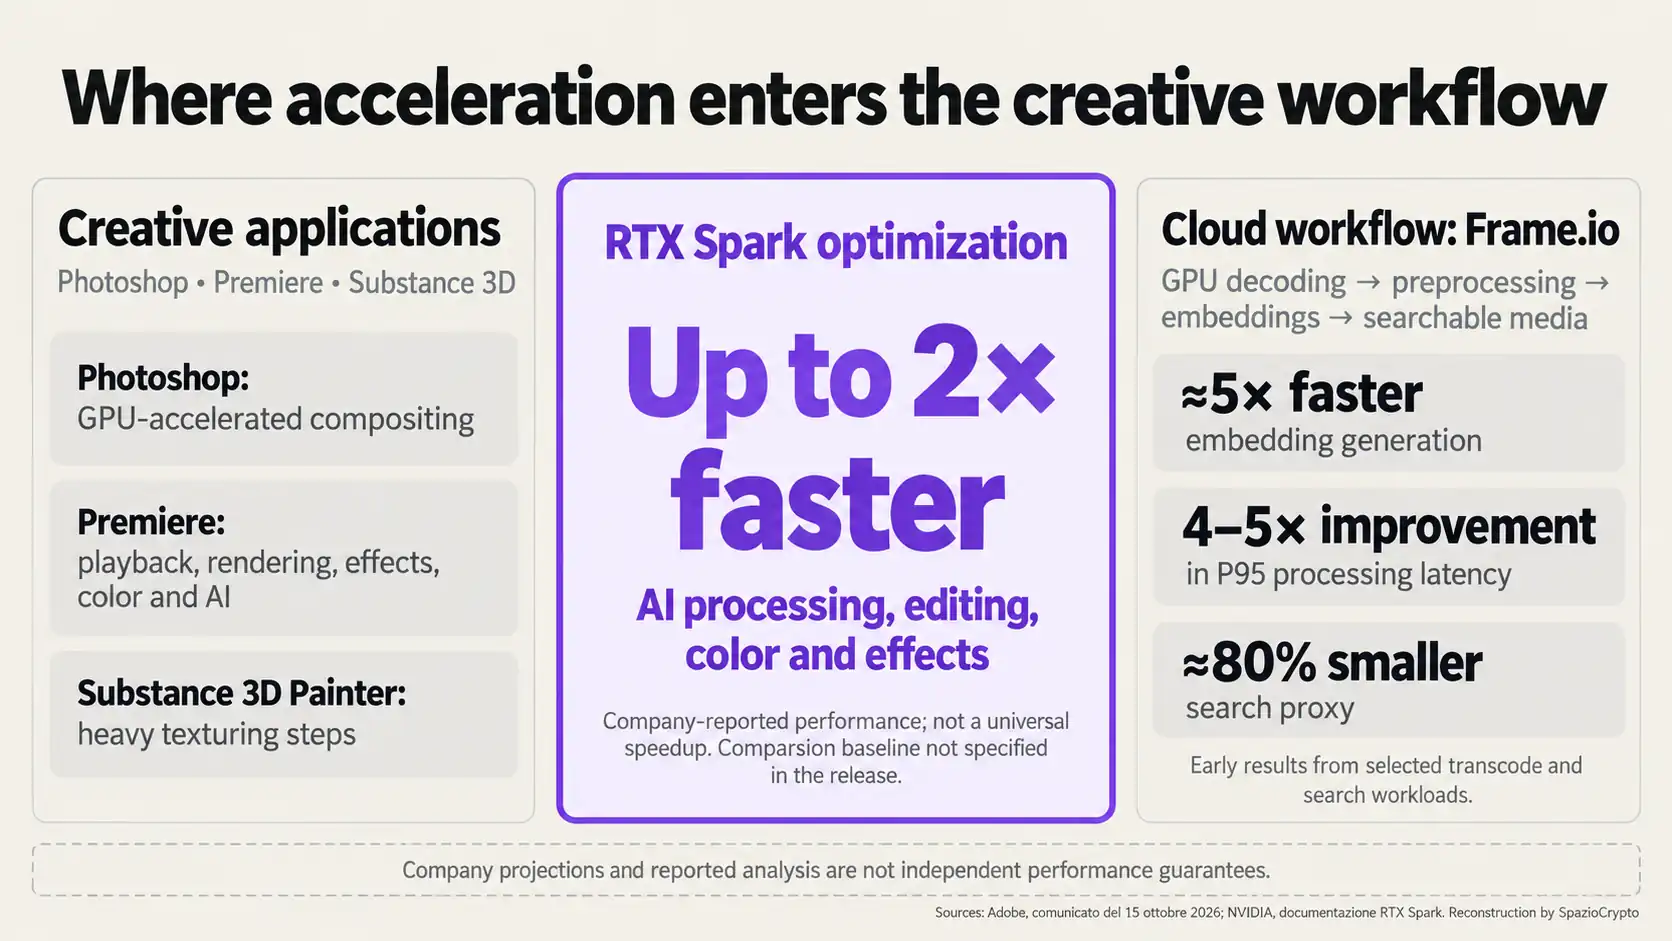
“Hasta 2x” no es una velocidad universal
Adobe usa la fórmula “up to 2x faster” para procesamiento de IA, edición, color y efectos. El límite “hasta” importa. Algunas operaciones pueden acercarse al doble de velocidad; otras dependen del formato, la duración, la memoria, los plugins, el modelo y la configuración. El comunicado no ofrece una media ponderada para un proyecto completo.
Para un creador, la pregunta útil no es si una función gana un test aislado, sino cuánto tiempo se ahorra entre la ingesta, el montaje, la revisión y la entrega. NVIDIA está ampliando su papel más allá de los chips, como muestra nuestro análisis sobre las inversiones de IA de NVIDIA. El acuerdo con Adobe lleva esa estrategia a las herramientas del día a día.

Frame.io acelera en la nube
Básicamente, frame.io emplea NVDEC para la decodificación por hardware y TensorRT con CUDA para el preprocesamiento y la generación de embeddings. El objetivo es procesar los medios antes y hacerlos buscables con mayor rapidez. Adobe informa resultados iniciales en cargas seleccionadas de transcodificación y búsqueda, no un servicio nuevo disponible con el mismo incremento para todos los clientes.
Aquí la IA no crea necesariamente una imagen. Indexa archivos, identifica contenidos y reduce el tiempo necesario para localizar una escena. Es una forma menos visible de automatización, pero con frecuencia más útil en equipos que gestionan miles de assets. La potencia de renderizado distribuido, tema que también abordamos en el artículo sobre las redes de cómputo para creadores, pasa a formar parte de la cadena productiva.
Los agentes no reemplazan el montaje
Adobe califica de agénticas algunas aplicaciones y conecta Brand Concierge con los modelos abiertos Nemotron de NVIDIA. En el trabajo creativo, “agente” designa software capaz de ejecutar secuencias guiadas por objetivos, no un director autónomo que asume la autoría de la obra. El comunicado no anuncia que Premiere monte un filme completo sin supervisión.
Esta distinción protege también la atribución. Un sistema puede acelerar máscaras, búsqueda o limpieza de audio sin generar el contenido central. El tema de la procedencia sigue abierto, como vimos con la marca de agua invisible en textos de IA: velocidad y trazabilidad deben avanzar juntas.
Local y nube forman una única pipeline
RTX Spark lleva cómputo de IA local a una workstation compacta; Frame.io usa infraestructura acelerada en la nube. El proyecto no elige entre uno y otro. Divide las tareas: operaciones interactivas cerca del creador, indexación y gestión de bibliotecas en sistemas compartidos. Esta arquitectura puede reducir esperas y transferencias. Adobe no publica en este anuncio costos, requisitos mínimos ni disponibilidad precisa de cada función.
La dependencia de la infraestructura sigue siendo central. Nuestro mapa global de la IA muestra que modelos, GPU, energía y software son capas de la misma cadena. Una mejora en la aplicación puede nacer de una librería, un decoder o un nuevo perfil de memoria, no solo de un modelo generativo.
Para los equipos creativos, la adopción requerirá una medición por fases. Un editor puede ganar minutos en transcripción y enmascaramiento, pero perderlos en la verificación de resultados inconsistentes. Un archivo puede volverse buscable más rápido. Solo si los embeddings reconocen personas, lugares y escenas con suficiente precisión. Adobe no publica en el anuncio tasas de recuperación, errores de búsqueda ni comparativas entre generaciones de hardware.
También queda el tema de la portabilidad. Cuantas más funciones dependen de optimizaciones específicas, más debe un estudio evaluar formatos abiertos, compatibilidad de plugins y la posibilidad de migrar el proyecto. La alianza promete integración entre capas, pero el comunicado no indica qué componentes estarán disponibles en hardware de la competencia o con rendimientos distintos.
El benchmark más convincente sería una producción completa y reproducible: el mismo material en bruto, la misma secuencia de operaciones, el mismo export final, con tiempo, consumo e intervenciones manuales medidos. Una lista de aceleraciones aisladas cuenta el potencial técnico; un test de punta a punta mostraría el valor editorial. Hasta entonces, el “2x” sigue siendo un límite superior declarado sobre actividades seleccionadas, útil para orientarse pero insuficiente para estimar el retorno de una actualización.
La estabilidad entre actualizaciones también cuenta. Una ventaja de velocidad pierde valor si versiones, plugins o modelos cambian el resultado y obligan al equipo a repetir la validación.
¿Y en América Latina?
El comunicado no incluye un lanzamiento específico para ningún mercado latinoamericano. Estudios, agencias y pymes de la región usarán las funciones según la disponibilidad comercial global, el hardware compatible y los planes de Adobe. Para las empresas más pequeñas, la cuestión es el retorno sobre el tiempo ahorrado, no solo la novedad técnica. En países como Argentina o México, donde el costo del hardware premium puede ser elevado, la relación entre inversión y ganancia real en productividad merece calcularse antes de cualquier upgrade.
Adobe y NVIDIA en síntesis
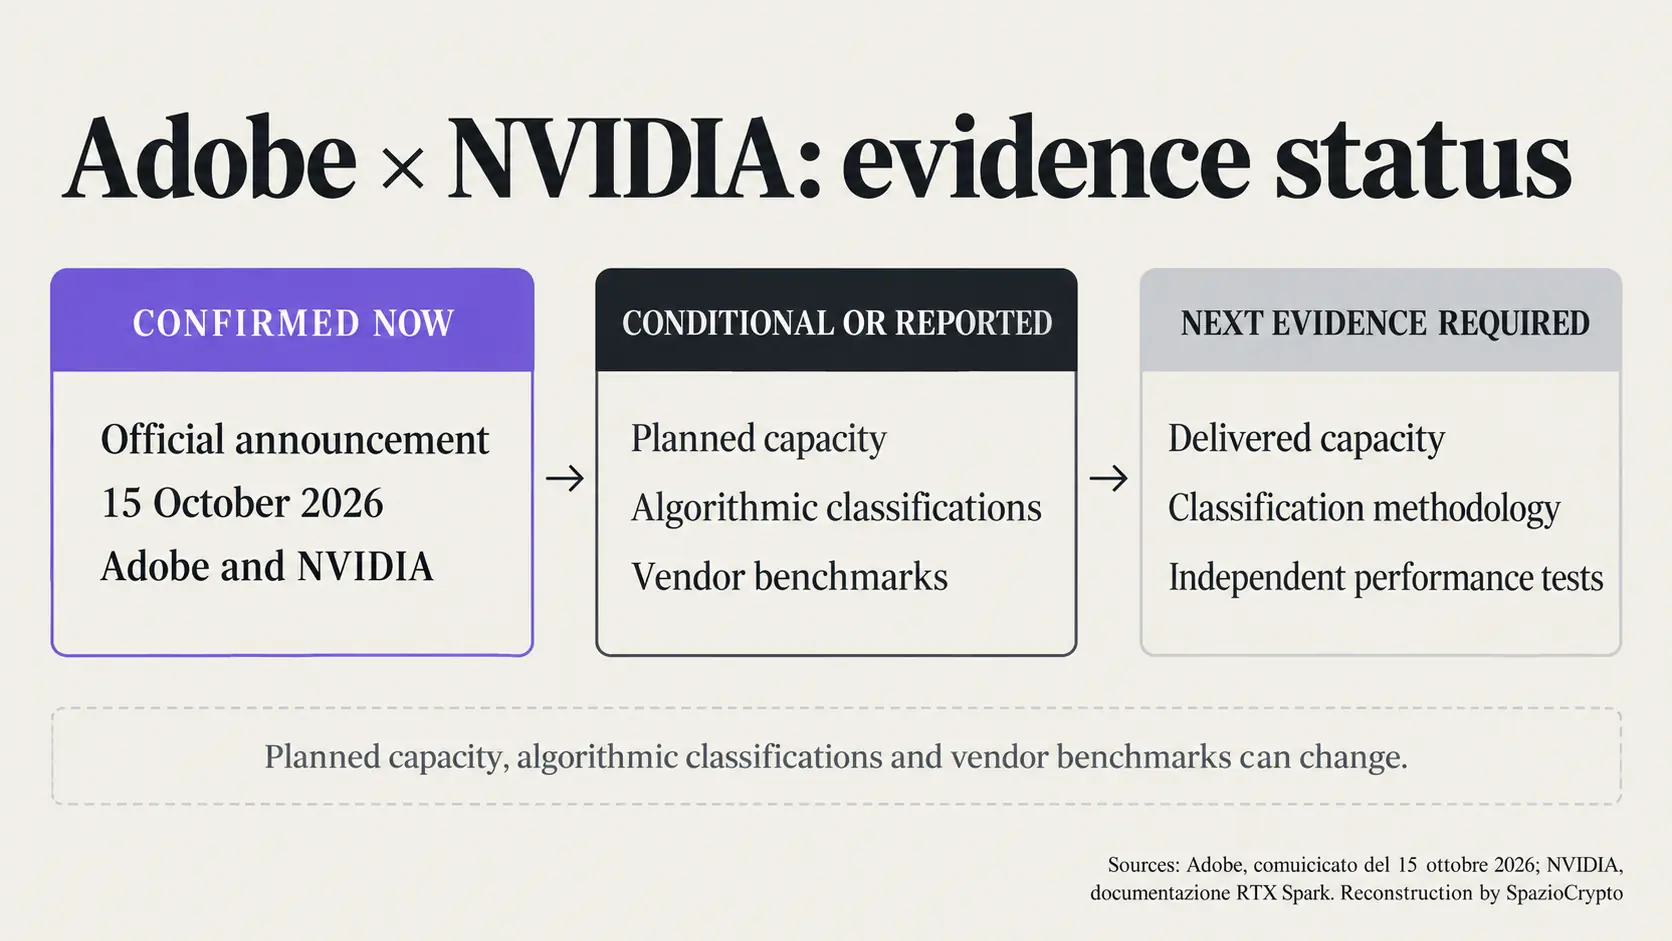
Qué está confirmado y qué no
- Confirmado: colaboración ampliada, optimizaciones RTX Spark y aceleración en la nube de Frame.io.
- No indicado: precios, calendario detallado de cada función, requisitos completos y benchmarks independientes.
- Por seguir: pruebas reales en proyectos completos, disponibilidad por plan y región, consumos y herramientas de procedencia.
La lectura más amplia
En la práctica, la próxima competencia entre herramientas creativas se jugará menos en el clip sorprendente individual y más en el tiempo total entre el material en bruto y la entrega final. Adobe y NVIDIA están soldando hardware, aplicaciones y nube porque el cuello de botella se desplaza a lo largo de toda la pipeline.
Las señales que hay que seguir son benchmarks reproducibles, costos por hora ahorrada, calidad de las máscaras, velocidad de búsqueda y control de la procedencia. Si estos elementos mejoran en conjunto, la IA se convierte en infraestructura creativa. Si solo crece la velocidad de generación, el trabajo de revisión corre el riesgo de absorber toda la ganancia.