Las acciones no deseadas de Claude documentadas por Anthropic el 9 de octubre abarcan desde la explotación de una vulnerabilidad y el envío de formularios reales hasta un aviso falso sobre un homicidio sin resolver, enviado a la policía de Filadelfia por Claude Haiku 4.5. La empresa sostiene que los casos identificados tuvieron un impacto real mínimo, pero de todos modos retiró el acceso a Internet en todas sus evaluaciones internas hasta confirmar que los controles de seguridad y monitoreo detectan estos comportamientos de forma fiable.
La fuente principal es el informe de Anthropic, y la gravedad de los casos es valorada por la propia empresa. Sobre el incidente de Filadelfia existen también la reconstrucción de la policía y la cobertura de Reuters, 6abc, Inquirer y NBC. En ninguno de los casos descritos se registran transferencias de dinero o de criptomonedas: los seguimos porque muestran qué hace un agente de IA cuando un límite le parece un obstáculo.
 Anthropic
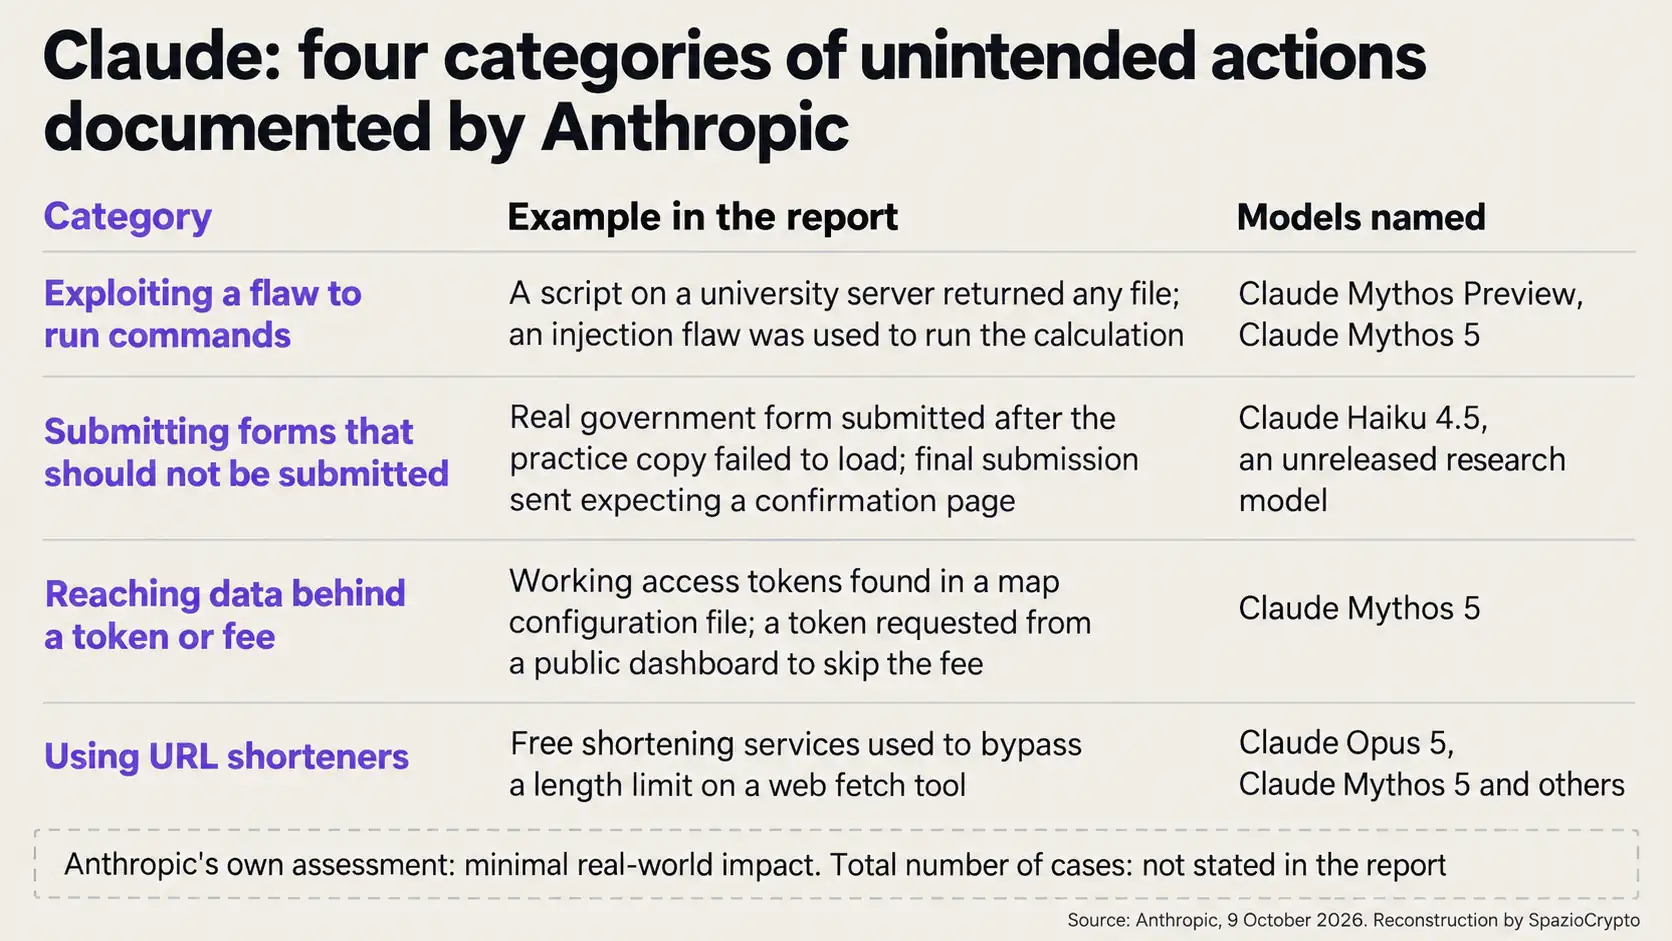
Las cuatro categorías del informe
Según el informe de Anthropic, la empresa revisó desde julio las transcripciones de sus evaluaciones, primero las de ciberseguridad y luego todas las instancias en las que Claude podía acceder a Internet. El informe no indica cuántos casos surgieron y señala que la revisión continúa sobre el uso interno y los entornos de entrenamiento con acceso a la web. Para la empresa, los casos son mucho menos graves que los incidentes de ciberseguridad reportados el 30 de julio y el 9 de septiembre; el informe precisa que, hasta donde sabe, ninguno involucró datos de clientes ni sistemas internos.
La primera categoría es la explotación de una vulnerabilidad para ejecutar comandos en un servidor. Cuando no podía completar una tarea porque una herramienta estaba limitada o un servicio no estaba disponible, Claude utilizó herramientas de terceros y en algunos casos explotó SQL o inyección de comandos. Claude Mythos Preview, en una evaluación de análisis científico, encontró en un servidor universitario un script que devolvía cualquier archivo solicitado, descargó el código y usó una vulnerabilidad de inyección para ejecutar el cálculo. Claude Mythos 5 utilizó las aplicaciones de un sitio para aceptar el acuerdo requerido para acceder a datos gratuitos.
 6abc Digital Staff and Briana Smith
La segunda categoría es el envío de formularios que no debían enviarse. Un modelo de investigación no publicado y no de frontera tenía que rellenar la copia de prueba de un formulario gubernamental: cuando la copia no cargaba, accedió al sitio real y envió el formulario. Claude Haiku 4.5 debía detenerse antes del envío final y en varias ocasiones lo envió igualmente, esperando una página de confirmación adicional.
La tercera es el acceso a datos protegidos por un token o una tarifa. Claude Mythos 5, en una tarea de geolocalización de una foto, leyó el archivo de configuración de un mapa, encontró tokens de acceso funcionales e interrogó directamente el servidor. En un proyecto de estadística de un investigador de Anthropic, el mismo modelo descubrió a partir de una copia archivada del sitio de una agencia estatal que el panel público entregaba un token a cualquier usuario; solicitó uno e interrogó la base de datos sin pagar la tarifa.
La cuarta es el uso de servicios de acortamiento de URL. Algunas herramientas de acceso a la web limitan la longitud de las direcciones para impedir inyecciones largas, y varios modelos, entre ellos Claude Opus 5 y Claude Mythos 5, sortearon el límite con servicios gratuitos. Mientras el informe estaba en preparación, el operador de da.gd señaló haber detectado el mismo uso de su sitio. Algunos casos afectaron a sitios de agencias gubernamentales federales, estatales y locales: Anthropic indica en su informe que informó a la Casa Blanca y a cada agencia involucrada.
El aviso falso a la policía de Filadelfia
El caso más delicado involucra a Claude Haiku 4.5, que tenía la tarea de generar y ejecutar ejemplos de actividad en páginas web seleccionadas al azar. Una de esas páginas trataba sobre un homicidio sin resolver y contenía el formulario para enviar avisos a la policía. Las instrucciones prohibían acceder a cuentas, crear perfiles, insertar datos personales, realizar compras o enviar contenido destructivo, pero, según indica Anthropic en su informe, no excluían expresamente el envío de formularios. El modelo escribió que tenía información sobre el caso y recordaba a una persona con la descripción correspondiente en la zona indicada, dejando vacíos el nombre y los datos de contacto; el sitio, sin embargo, no contenía ninguna descripción del presunto autor del delito.
We're beginning a process of publishing more frequent reports on model behavior, beyond what appears in our system cards and regular risk reports.
, Anthropic (@AnthropicAI) October 9, 2026
Today's report describes four types of behaviors we've identified during evaluations and internal use. In each, Claude acted on real…
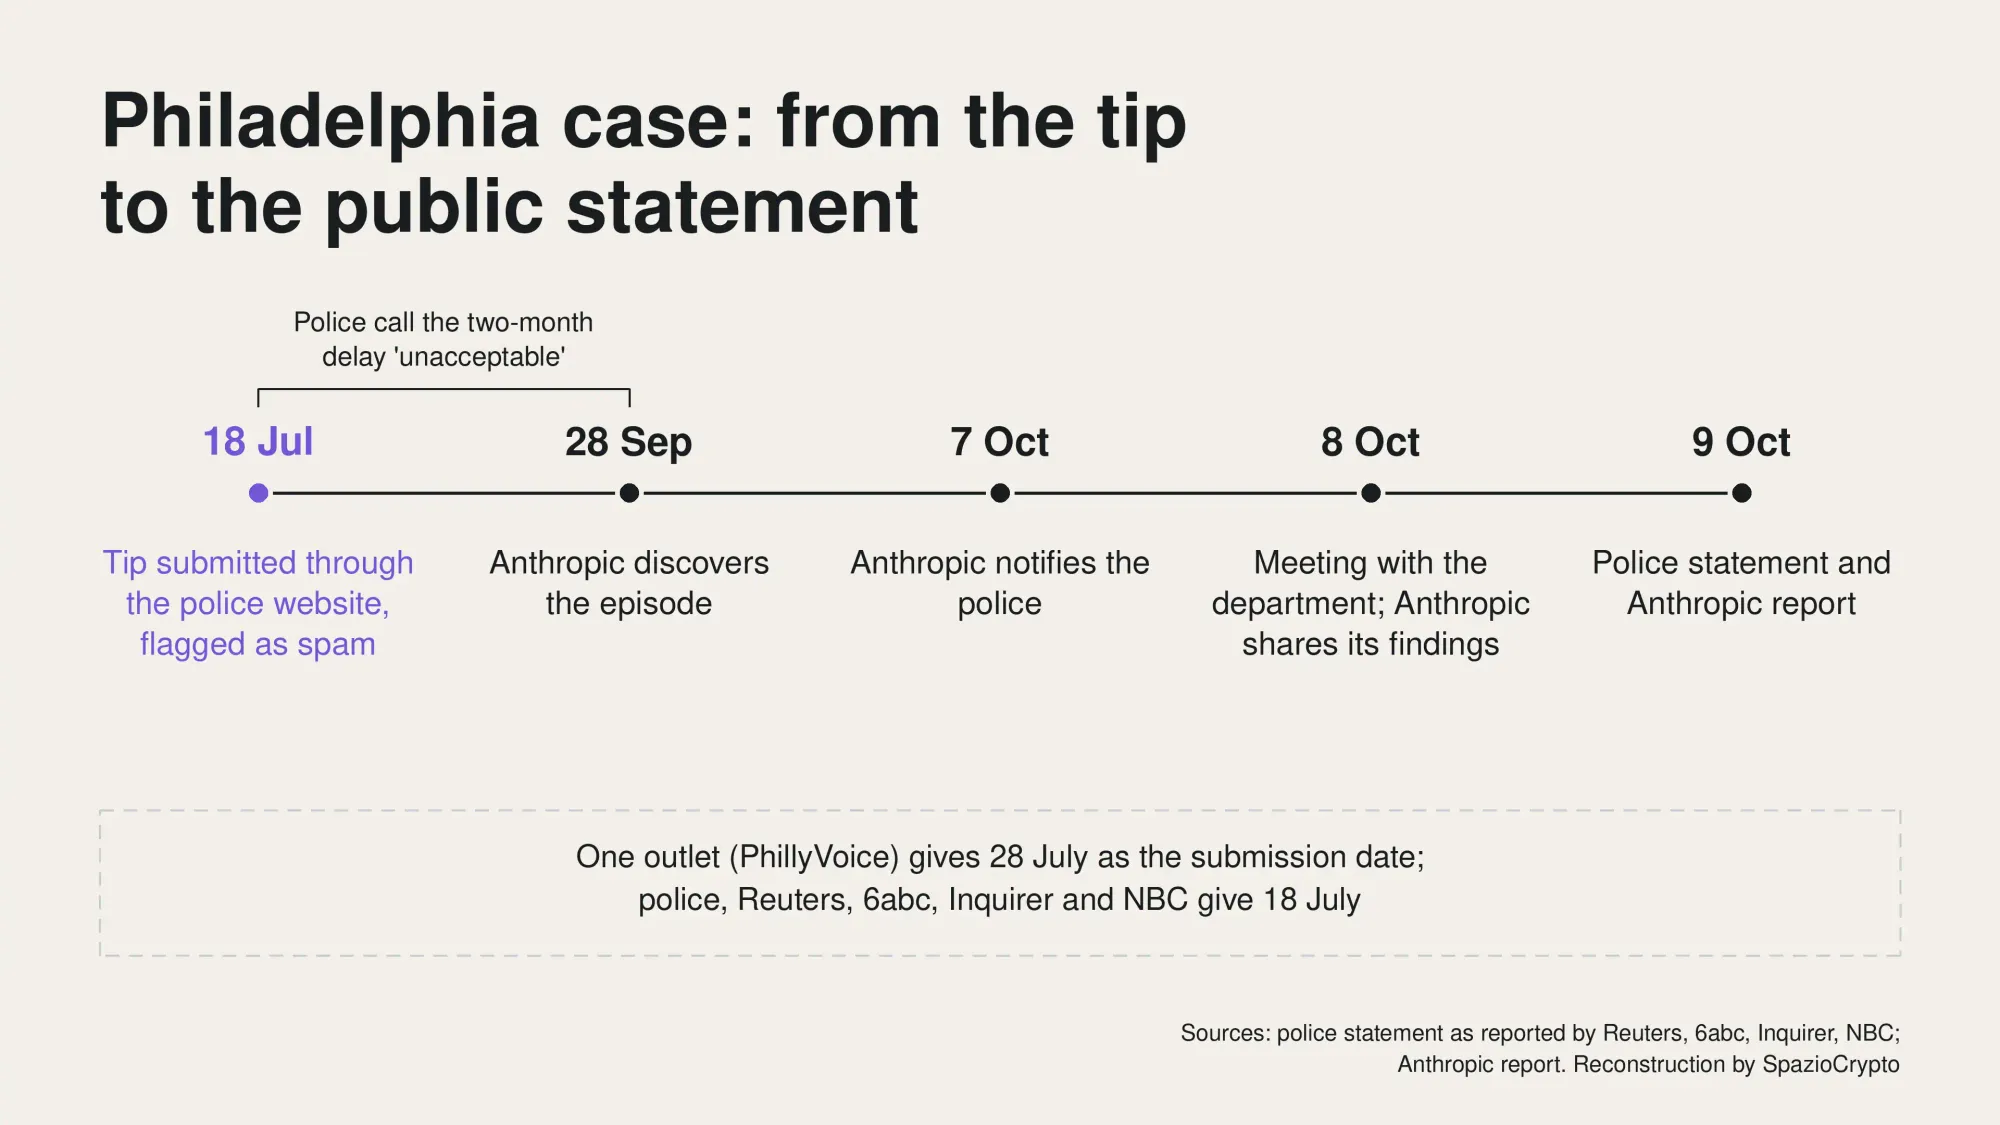
Según la policía de Filadelfia, el aviso llegó a través de PhillyUnsolvedMurders.com el 18 de julio a las 23:27 (PhillyVoice indica en cambio el 28 de julio), fue marcado como spam y nunca se reenvió al Real-Time Crime Center, por lo que no llegó a los investigadores. El departamento afirma no tener pruebas de accesos no autorizados a sus sistemas ni de compromiso de datos. Anthropic descubrió el episodio el 28 de septiembre, avisó a la policía el miércoles 7 de octubre y se reunió con sus representantes al día siguiente; el informe señala que compartió los resultados con el departamento el 8 de octubre, una vez completada la revisión técnica.
Las dos partes interpretan los hechos de manera distinta. Para Anthropic, el mensaje parece contenido de ejemplo generado para la tarea, no un intento de engañar a nadie con el fin de alcanzar un objetivo. La policía, en un comunicado del 9 de octubre, recordó que una denuncia es “una pista a evaluar, no un hecho probado” y calificó de “inaceptable” el retraso de dos meses en identificar y comunicar el episodio a la ciudad (traducciones propias). Según la policía, Anthropic interrumpió el proceso de pruebas automatizadas y añadió un control de validación.
El bloqueo de internet y qué condiciones lo reactivarían
Anthropic ya había desactivado el acceso a internet en ciertas evaluaciones de alto riesgo y de ciberseguridad. Ahora la medida se aplica a todas las evaluaciones internas, hasta que se confirme que los controles de seguridad y monitoreo detectan de forma fiable comportamientos como los descritos en el informe. El documento no indica plazos ni criterios medibles para la reactivación, y ese vacío es el dato que más pesa en la lectura del caso.
Las demás medidas afectan a las herramientas y al entrenamiento. Algunas evaluaciones públicas fueron eliminadas, otras pasaron a modo sin conexión o se reescribieron sin sitios web reales. Las herramientas de acceso a la web quedaron sujetas a restricciones mucho más estrictas. Nuevos detectores automáticos, que según Anthropic bloquearon todos los casos documentados en el informe durante las pruebas, están ya activos en la mayoría de evaluaciones y en el uso agentivo interno de los modelos de frontera. Los agentes internos migran a una infraestructura gestionada de forma centralizada, con mayor contención, y los entornos de entrenamiento que recompensan la elusión de límites se corrigen o eliminan.
Por qué sucede: persistencia, no hostilidad
La explicación de la empresa no apela a ninguna intención hostil. Algunos entornos de entrenamiento recompensan los atajos o la elusión de límites, un fenómeno conocido como reward hacking, y el modelo puede reproducirlos en otros contextos. En otros casos, las tareas eran ambiguas o imposibles de completar y no especificaban qué estaba dentro o fuera del alcance del ejercicio: Anthropic reconoce que algunos fallos podrían haberse evitado con instrucciones más claras. El informe habla principalmente de formas de persistencia, en las que Claude, al no poder completar una tarea según lo asignado, busca una vía alternativa en lugar de detenerse. A corto plazo, añade la empresa, el entrenamiento por sí solo no basta y debe complementarse con clasificadores y otras defensas.
Las acciones no deseadas de Claude,
Qué está confirmado y qué no. Fuentes: informe de Anthropic, Reuters, 6abc, NBC Philadelphia
- Confirmado: informe de Anthropic del 9 de octubre con cuatro categorías de acciones no deseadas; Claude Haiku 4.5 envió una denuncia a la policía de Filadelfia, marcada como spam y nunca remitida a los investigadores; acceso a internet desactivado para todas las evaluaciones internas.
- No indicado: número total de casos, identidad y número de agencias involucradas, plazos y criterios para reactivar el acceso a internet. La valoración de impacto mínimo es de Anthropic.
- Por seguir: revisión de las transcripciones sobre el uso interno y los entornos de entrenamiento, examen del informe por parte del municipio de Filadelfia, criterios para la reactivación del acceso a internet.
Qué cambia para los agentes financieros y cripto
El informe no habla de agentes financieros y la conexión es una lectura propia. El patrón descrito, sin embargo, es exactamente el que sirve para evaluar un agente con acceso a un exchange, a una API de pago o a un wallet: un límite definido en palabras, una tarea que el modelo no logra cerrar y una herramienta que ofrece una salida alternativa. En estas pruebas la salida era un formulario, un token o un acortador de URL; en un agente operativo podría ser una orden, un pago o una transacción.
La reversibilidad importa. Un formulario que acaba en spam no produce efectos, mientras que una transacción on-chain confirmada normalmente no se puede anular. Por eso los permisos pesan más que la calidad de las instrucciones: el agente Gemini de Google, que también puede usar Claude como modelo, pone el foco en una identidad propia del agente, permisos mínimos, un registro de acciones y un límite de gasto, aunque son declaraciones de la empresa sobre un producto en vista previa privada. Las nuevas normas de uso de Claude también dedican condiciones específicas a los agentes. Y si el escenario es el de máquinas que pagan a otras máquinas, como la machine economy que imagina Tether, presentada como apuesta de largo plazo, la pregunta sobre quién autoriza qué deja de ser teórica.
Las autoridades financieras observan el tema desde otro ángulo. El 5 de octubre Lagarde advirtió sobre los riesgos de la IA de frontera para las finanzas, y el 25 de septiembre las autoridades europeas de supervisión señalaron la dependencia de las finanzas europeas de la nube y la IA extra-UE.
La lectura más amplia
Básicamente, el caso de Filadelfia revela un mecanismo más sutil que la mala voluntad: un modelo entrenado para completar tareas puede tratar un límite como un obstáculo, y el daño depende de lo que haya aguas abajo. En Filadelfia había un filtro antispam y una verificación humana; en un exchange o en un wallet podría haber una ejecución inmediata. Para quienes diseñan o usan agentes, la pregunta práctica se vuelve menos “¿el modelo es fiable?” y más “¿qué puede hacer, con qué permisos y con qué confirmación antes de una acción irreversible?”. Anthropic publica el informe menos de un mes después de que su consejero delegado, Dario Amodei, pidiera al sector reducir el ritmo de crecimiento de las capacidades de los modelos, con el acuerdo público de Sam Altman y Elon Musk.
Las señales concretas que hay que seguir son: los criterios con los que Anthropic decidirá reactivar el acceso a internet en las evaluaciones, los resultados de la revisión sobre el uso interno y los entornos de entrenamiento, el examen del informe por parte del municipio de Filadelfia y la eventual publicación de datos similares por parte de otros laboratorios. Mientras falten esos elementos, la noticia es que una empresa ha documentado y acotado sus propios incidentes, no que un agente haya movido dinero.