Genie 4, el nuevo modelo de Google DeepMind presentado el 27 de octubre, genera entornos explorables en tiempo real con sonidos, música y diálogos producidos junto con las imágenes. El usuario se mueve con teclado y ratón y puede modificar la escena mientras la simulación está activa, escribiendo en lenguaje natural. Por ahora solo lo utiliza un grupo reducido de testers seleccionados. El acceso para los suscriptores de Google AI Ultra en Project Genie y para los socios de las API está anunciado como “próximamente”, sin fechas concretas. Y la propia DeepMind reconoce por escrito que objetos, coherencia y física todavía pueden fallar.
Esta información proviene del anuncio de DeepMind firmado por Raia Hadsell, Diego Rivas y Hang Qi, del blog oficial de Google y de la página del modelo. No fue posible acceder directamente al post en X ni reproducir la demo en YouTube: el texto del post se verificó a través del embed publicado por AI Lately. Las especificaciones de Genie 3 proceden de la cobertura de The Decoder de agosto de 2025.
This is Genie 4, our most realistic and interactive world model yet. 🌐
, Google DeepMind (@GoogleDeepMind) October 27, 2026
Explore dynamic environments in real time to see how the scene responds, sounds, and how the people in it move, react, and speak. pic.twitter.com/6mmSUm9BBO
Qué hace
Genie 4 es un modelo del mundo: no produce un vídeo para ver, sino un entorno que responde a comandos fotograma a fotograma. Se parte de un texto o de una imagen de referencia usada como primer fotograma. Luego se explora con los controles de teclado para movimiento y cámara. Durante la sesión se puede cambiar el clima, mover el encuadre, añadir personas u objetos. Según DeepMind, un modelo Gemini adapta cada solicitud a la escena y mantiene el mundo en movimiento incluso entre un comando y otro.
El modelo bebe de la familia Gemini. Gemini Omni ancla las escenas al aspecto y comportamiento del mundo real, mientras otros modelos Gemini gestionan el razonamiento que mantiene coherente la simulación. Es la misma familia que Google está impulsando en el trabajo de oficina con el agente Gemini para empresas, también en fase de acceso reservado.
El salto declarado: el audio
DeepMind presenta Genie 4 como el primer modelo del mundo en tiempo real capaz de generar audio de forma nativa. Cada entorno tiene sus propios sonidos de fondo y música. Los personajes hablan y el diálogo se adapta a comandos y eventos.
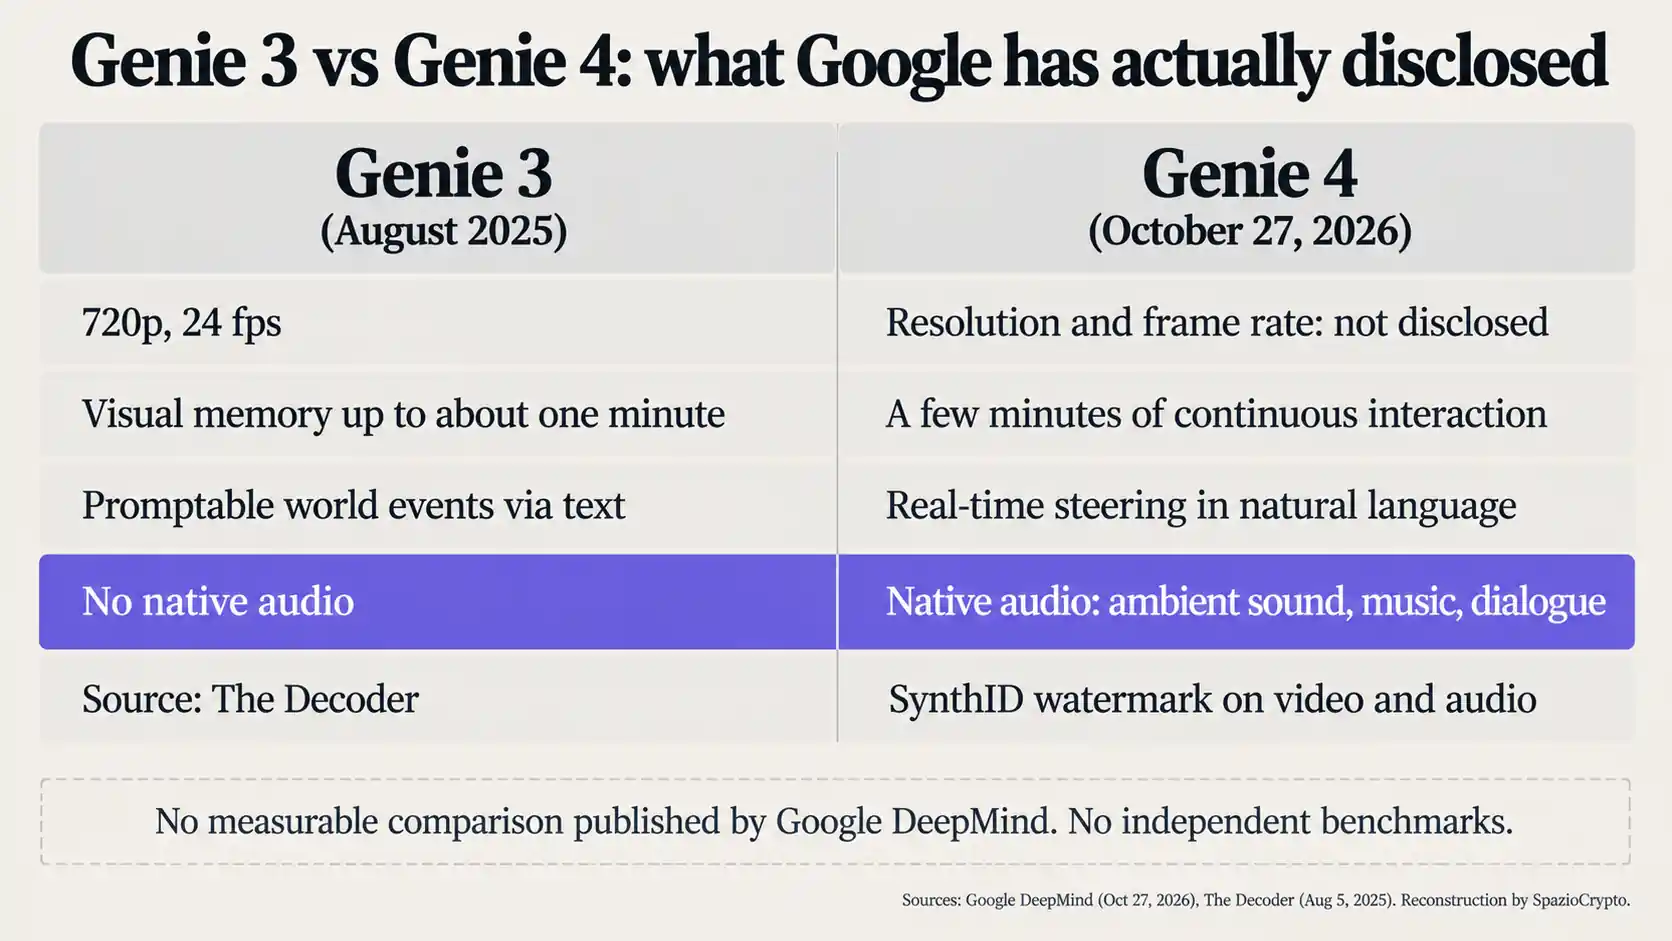
Aquí está la diferencia respecto a Genie 3, anunciado en agosto de 2025. Según The Decoder, ese modelo generaba mundos a 720p y 24 fotogramas por segundo, con una memoria visual de hasta un minuto y cambios de escena mediante texto, denominados promptable world events. El audio no existía. Para Genie 4, DeepMind no publica ni resolución ni fotogramas por segundo, ni una duración en minutos, y no ofrece ninguna comparación medible con la versión anterior. La página del modelo solo habla de “unos pocos minutos de interacción continua” (traducción propia).
Prototipo interactivo, no vídeo
La distinción importa para entender para qué sirve. Un generador de vídeo produce un clip cerrado. Genie 4 produce una escena que reacciona a quien la conduce. DeepMind enumera usos concretos: avances para directores que pueden rodar más tomas en una simulación en vivo, fotoperiodistas que intentan convertir una sola foto de archivo en un entorno, desarrolladores que prueban estilos visuales y mecánicas de juego a partir de un texto, socios empresariales que evalúan la generación rápida de escenarios. Son flujos que se suman a las herramientas ya usadas entre los creadores, como las que Adobe y NVIDIA están acelerando.
El terreno más estratégico es la simulación para agentes y robots. En el anuncio, Gemini 3.8 Flash observa los fotogramas, divide un objetivo en pasos, verifica cada uno y corrige el plan cuando el mundo cambia o el usuario interviene. En otra demo, Gemini 4 Argon trabaja con Genie 4 en una tarea robótica con el robot Apollo de Apptronik y una partida de damas. Entrenar agentes en mundos generados es la misma apuesta de la IA física de NVIDIA y LG. Pero entre una demo y una línea de producción hay una distancia que los robots humanoides en fábrica ilustran bien.
Los límites, escritos por DeepMind
El anuncio no oculta los puntos débiles. Los detalles visuales y la permanencia de los objetos pueden desviarse, especialmente en sesiones largas, tras múltiples modificaciones mediante texto o durante la navegación. Permanecen como objeto de investigación las interacciones físicas complejas, la precisión del audio en tiempo real, el texto legible, la precisión espacial y la coherencia a largo plazo.
La página del modelo añade otros tres límites. El primero es la interacción entre varios agentes y varios usuarios en el mismo entorno. El segundo son los lugares reales, que no pueden reproducirse con precisión. El tercero es la duración: pocos minutos, no sesiones extendidas. Una nota advierte que las grabaciones mostradas son sesiones reales pero abreviadas, con resultados de carácter ilustrativo. No existe ningún benchmark ni evaluación independiente: lo que se ve es una demostración corporativa.
Quién puede probarlo, y cuándo
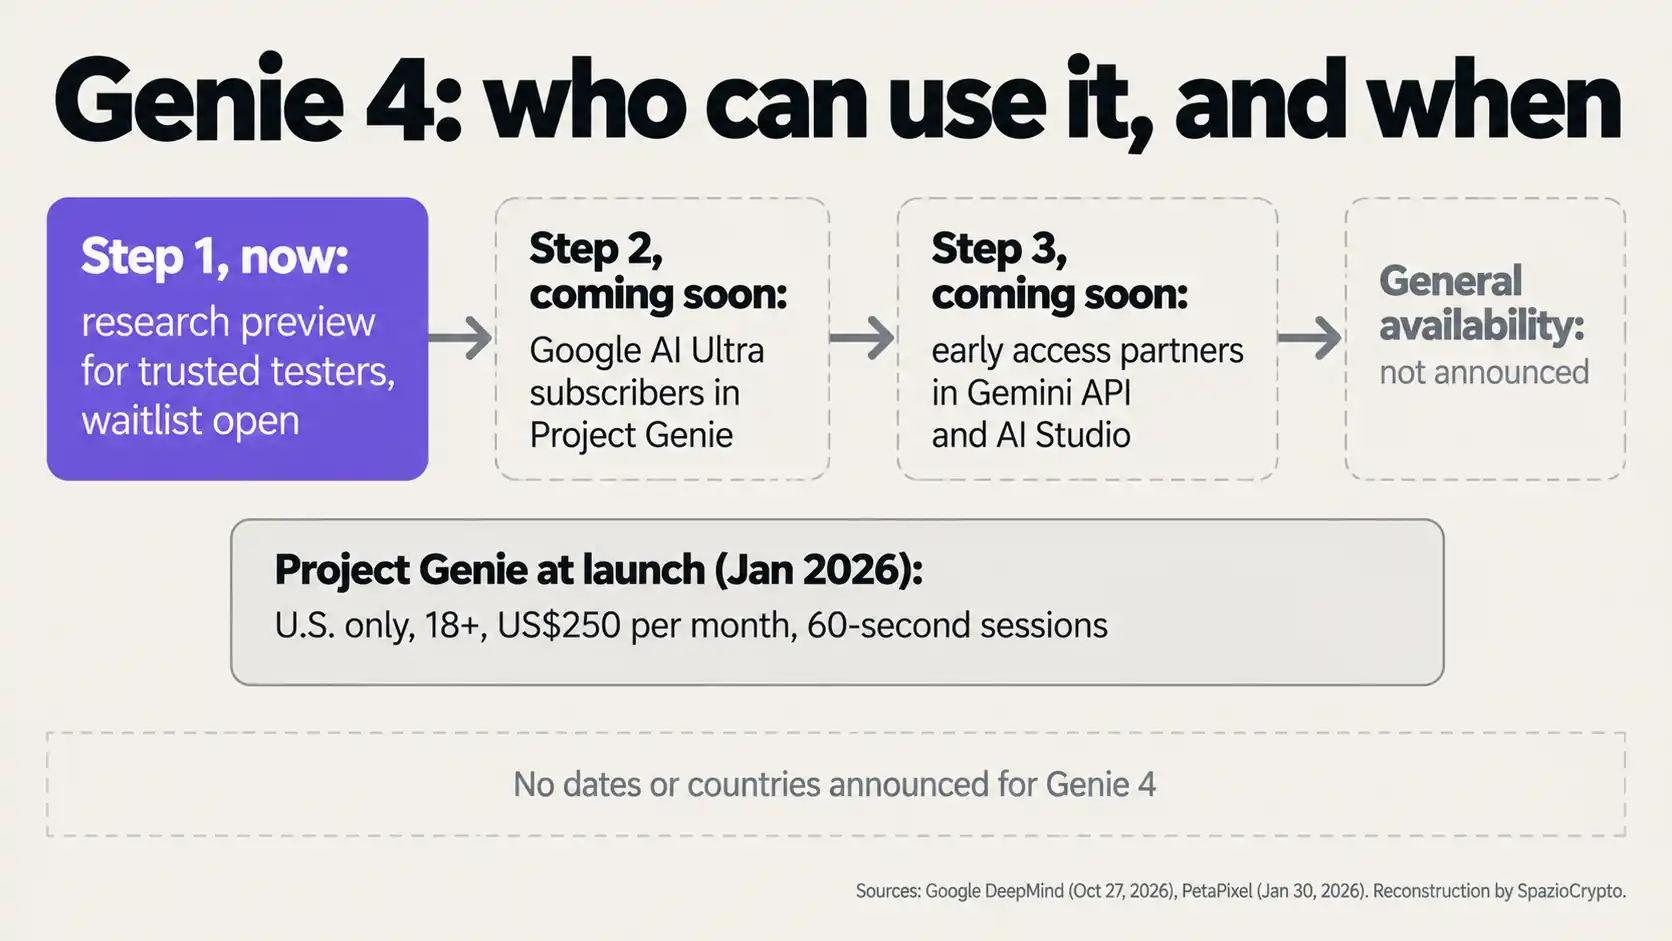
La respuesta corta: casi nadie, por ahora. El modelo está en fase de vista previa de investigación para testers de confianza, con una lista de espera abierta. Después le tocará a los suscriptores de Google AI Ultra dentro de Project Genie, y a los socios con acceso anticipado a la API Gemini y a AI Studio. Sin fechas, sin países indicados.
El precedente ayuda a calibrar las expectativas. Project Genie nació el 29 de enero de 2026 con Genie 3 y, según PetaPixel, en el lanzamiento estaba reservado a los suscriptores Ultra en Estados Unidos, mayores de edad, a 250 dólares al mes, con generaciones limitadas a 60 segundos. No se sabe si ese perímetro se ha ampliado. Para los usuarios de habla hispana, por tanto, no existe hoy un camino de acceso confirmado. En materia de transparencia, DeepMind declara que todos los vídeos y audios generados por Genie 4 llevarán la marca de agua SynthID: un tema con peso propio, tras casos como el del vídeo premiado y luego descalificado por Nikon por uso de IA generativa.
Genie 4
Qué está confirmado y qué no
- Confirmado: modelo del mundo en tiempo real con audio nativo, escenas modificables mediante texto durante la sesión, vista previa para testers seleccionados, marca de agua SynthID en vídeos y audios, límites declarados sobre objetos, física, audio y duración.
- No indicado: resolución, fotogramas por segundo, duración en minutos, países y fechas de disponibilidad, precios de la API, benchmarks o evaluaciones independientes.
- A seguir: la apertura a los suscriptores Ultra en Project Genie y a los socios de la API, y las primeras pruebas independientes sobre coherencia y física.
La lectura más amplia
Básicamente, nuestra lectura, que declaramos como tal, es que Genie 4 desplaza la carrera de la IA generativa del clip al mundo. El vídeo se mira, el entorno se usa: se prueba un nivel de juego, se rueda una escena, se entrena un agente. Por eso los límites declarados pesan más que en un generador de vídeo. Un objeto que desaparece en un clip es un defecto estético. En un simulador para robots o agentes es un dato erróneo. El valor está en la prototipación rápida, no todavía en la simulación fiable.
Hay tres señales que conviene seguir. La primera: cuándo y dónde el acceso se ampliará más allá de los testers, y con qué duración de las sesiones. La segunda: si llegarán evaluaciones independientes sobre permanencia de objetos, coherencia y física, hoy ausentes. La tercera: cuánto el uso con agentes, como los que operan en el ordenador por cuenta de los usuarios, pasará de las demos a los flujos de trabajo reales.