Un proveedor afirma servir un modelo concreto de inteligencia artificial: ¿cómo puede el cliente verificarlo? El 2 de noviembre, Anthropic publicó FlashProve, un prototipo de código abierto que genera una prueba criptográfica para demostrar que una respuesta fue producida por un modelo específico, sin revelar sus pesos. La demostración se realizó sobre Llama 4 Maverick en una versión de 4 bits, con ventanas de 1.024 tokens. No es un servicio activo en las API de Claude, y el código se declara sin mantenimiento.
Hemos leído el artículo de investigación de Anthropic, firmado por investigadores de la empresa junto a académicos de EPFL y MIT, y el README del repositorio público en GitHub. La publicación en X con la que Anthropic anunció el trabajo el 3 de noviembre no se abre con nuestras herramientas. Los datos de rendimiento que citamos son declarados por Anthropic y no han sido medidos por terceros.
New Anthropic research: progress on provable inference for large language models.
, Anthropic (@AnthropicAI) November 3, 2026
Here, we introduce FlashProve. Building on established cryptographic techniques, FlashProve allows developers to verify whether a given response came from a given AI model. It's substantially more…
El problema: quién respondió realmente
Según Anthropic, hoy los usuarios no pueden verificar que las respuestas provengan del modelo que el desarrollador declara. El artículo señala dos riesgos. El primero son los servicios de enrutamiento que podrían sustituir el modelo prometido por uno más barato. El segundo son ataques que alteran el flujo de tokens entre el modelo y el usuario. Para quienes adquieren inteligencia artificial a través de plataformas intermediarias, el punto es concreto: pagan por un modelo y no tienen forma de comprobar cuál está trabajando.
El tema crece con la multiplicación de los canales de distribución, desde las nubes que revenden modelos de terceros, como ocurrió con la entrada de OpenAI en Google Cloud, hasta los modelos de pesos abiertos ofrecidos por varios proveedores a precios distintos, como MiniMax con su versión Flash.
Cómo funciona: compromiso, prueba, verificación
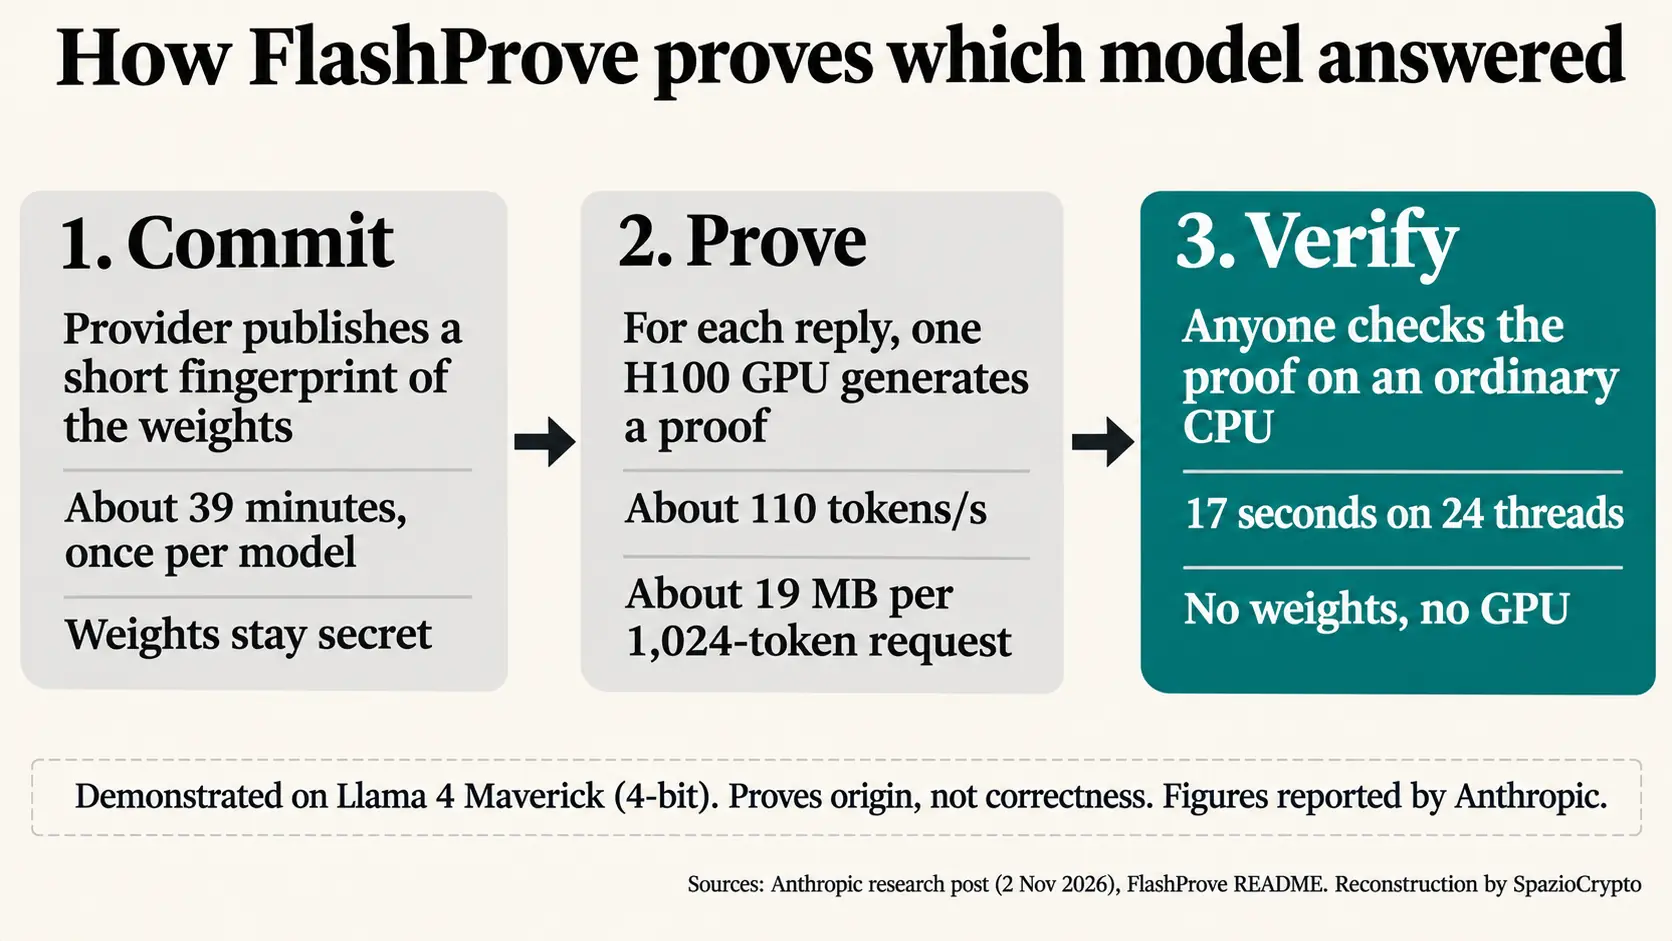
El sistema opera en tres pasos. Primero, el proveedor publica una huella breve que lo vincula a un conjunto preciso de pesos sin mostrarlos: según Anthropic, esta fase requiere aproximadamente 39 minutos una sola vez por modelo. Luego, para cada respuesta, la GPU del proveedor genera una prueba de que esa secuencia de tokens es el resultado del modelo comprometido. Por último, cualquiera puede verificar la prueba en un procesador convencional, sin pesos ni GPU, teniendo solo la huella, el prompt y la respuesta.
La técnica empleada es un zkSNARK, una prueba de conocimiento cero: demuestra que un cálculo se ejecutó correctamente sin revelar los datos utilizados. Es la misma familia de herramientas que el mundo cripto usa para la privacidad y la escalabilidad, y que instituciones financieras europeas han estudiado para conciliar privacidad y controles en los pagos digitales. Los pesos, los valores intermedios y la elección de expertos del modelo permanecen ocultos. La arquitectura, precisa Anthropic, no se oculta.
Los números del prototipo
Llama 4 Maverick es un modelo de 400 mil millones de parámetros con arquitectura de mezcla de expertos, de los cuales aproximadamente 17 mil millones están activos por token. El prototipo trabaja sobre una conversión pública a 4 bits. Según los datos publicados por Anthropic, en una sola GPU H100 con 24 núcleos de procesador, la fase de prueba avanza a unos 110 tokens por segundo, con pruebas de aproximadamente 19 megabytes por cada solicitud de 1.024 tokens. Verificar una prueba requiere 17 segundos en 24 hilos, y el cliente debe descargar unos 6,5 megabytes de datos de compromiso.
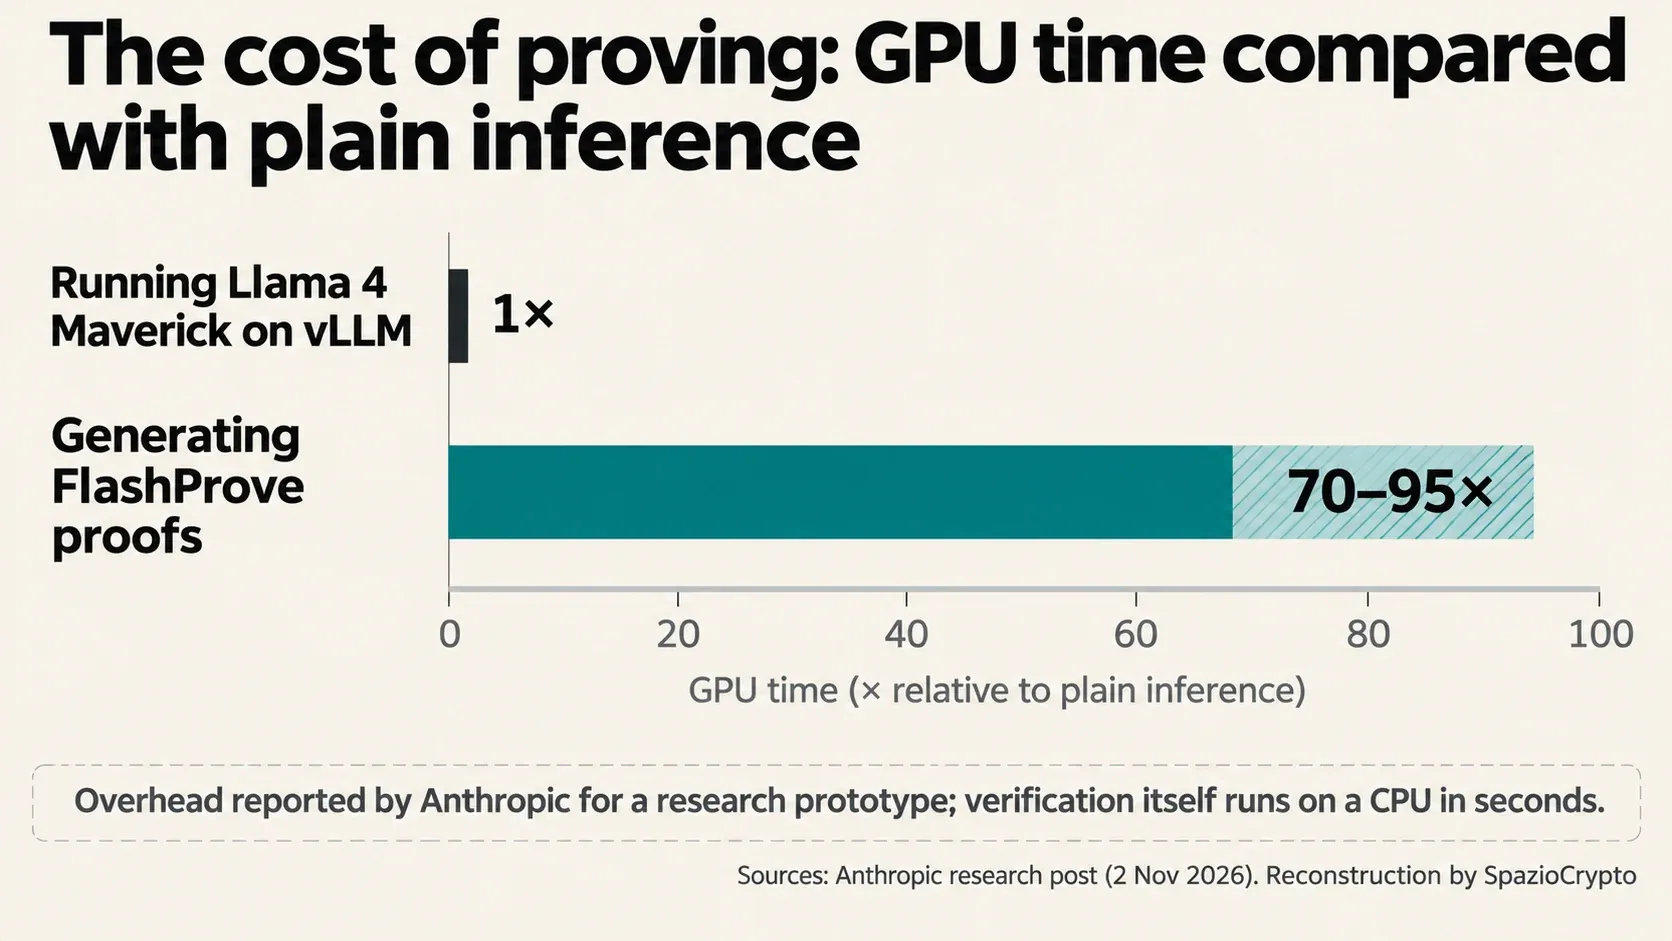
El coste es el dato más relevante. Según el artículo de Anthropic, generar las pruebas requiere entre 70 y 95 veces el tiempo de GPU necesario para ejecutar el modelo con vLLM, uno de los motores de inferencia más utilizados. Anthropic compara el resultado con otro trabajo, el de Attestable, que alcanza entre 53 y 77 tokens por segundo en un modelo denso de 31 mil millones de parámetros, aunque no ha publicado una librería de código abierto.
Lo que la prueba no garantiza
La prueba indica de qué modelo proviene una respuesta, no si esa respuesta es correcta. Anthropic enumera otros límites. La prueba cubre la decodificación determinista: con el muestreo, que introduce aleatoriedad en las respuestas, el resultado real podría divergir en algún punto. El modelo probado es una versión exacta e íntegra de los pesos, y una respuesta calculada en punto flotante podría alejarse de ella. La equivalencia aproximada no cubre prompts construidos específicamente para explotar las diferencias, y los ataques basados en los tiempos de respuesta quedan fuera del alcance.
Existen también límites prácticos. La ventana de 1.024 tokens es, en palabras de Anthropic, “bastante corta” para una conversación. El código C++ rápido no tiene garantías formales y no se garantiza que corresponda exactamente a la prueba escrita en el lenguaje Lean, donde la solidez del protocolo se demuestra matemáticamente. El README del repositorio es directo: es un artefacto de investigación, “sin mantenimiento” y que no acepta contribuciones. No indica auditorías de seguridad externas.
 Anthropic
¿Y en Italia?
Para las empresas y las administraciones públicas italianas que contratan servicios de inteligencia artificial a través de distribuidores o plataformas, FlashProve no cambia nada hoy: no es un producto y no está integrado en ningún servicio comercial. Señala, eso sí, una dirección posible. Un contrato que prometa un modelo concreto podría algún día verificarse mediante una prueba criptográfica, en lugar de depender de la confianza en el proveedor. Es el mismo paso que las pruebas de conocimiento cero han dado en los servicios financieros, donde Coinbase solicita su reconocimiento en la normativa antilavado de dinero de Estados Unidos.
 Steve Weis
El asunto también roza la dependencia tecnológica europea. Las autoridades de supervisión han advertido de que las finanzas de la Unión Europea dependen de inteligencias artificiales extranjeras, accesibles a menudo a través de múltiples capas de proveedores. Herramientas de verificación independientes del proveedor podrían convertirse en requisito contractual si los costes bajaran. Hoy, con una sobrecarga de entre 70 y 95 veces el tiempo de cómputo normal, según los datos publicados por Anthropic el 2 de noviembre, no es una opción realista para el uso cotidiano.
FlashProve
Qué está confirmado y qué no
- Confirmado: prototipo de código abierto con licencia Apache 2.0, publicado el 2 de noviembre; demostrado en Llama 4 Maverick a 4 bits con ventanas de 1.024 tokens; verificación en CPU en 17 segundos sin acceso a los pesos; coste de entre 70 y 95 veces el tiempo de GPU de la inferencia normal; código declarado sin mantenimiento activo.
- No especificado: auditorías de seguridad externas; costes económicos concretos; aplicación a las API de Claude u otros modelos; tiempos de verificación para contextos más largos.
- Aspectos a seguir: extensión a contextos más largos y otras arquitecturas; posibles adopciones por parte de proveedores o plataformas; verificaciones independientes del código.
La lectura más amplia
Básicamente, nuestra interpretación, declarada como tal: FlashProve traslada a la inteligencia artificial una idea nacida en el mundo cripto, la de no confiar sino verificar. Hoy el usuario de un servicio de IA debe creer al proveedor sobre qué modelo está usando, igual que antes había que creer a un intermediario sobre el saldo de una cuenta. La prueba criptográfica separa dos preguntas que suelen confundirse: de dónde viene una respuesta y si esa respuesta es correcta. FlashProve responde solo a la primera, y eso ya es un avance significativo. Queda por ver si alguien, incluida Anthropic, decidirá llevarla a los servicios reales, como otras iniciativas de transparencia, entre ellas el acceso de los evaluadores de METR al interior de Anthropic.
Hay tres señales que conviene vigilar. La primera es la reducción de la sobrecarga de cómputo, hoy entre 70 y 95 veces el coste base, sin la cual ningún proveedor podrá ofrecer pruebas por cada respuesta generada. La segunda es la extensión a contextos largos y a otros modelos, incluidos los de pesos cerrados como Claude. La tercera es si el código, abandonado por sus autores, será retomado por otros grupos o por plataformas interesadas en vender un origen verificable.