MiniMax lanzó MiniMax M3.1 Flash el 19 de octubre de 2026 con un precio de 0,15 dólares por millón de tokens de entrada y 0,60 dólares por millón en salida. El modelo ya está disponible a través de los servicios de la compañía, mientras que los pesos se publicarán más adelante. La novedad interesa a quienes construyen agentes y software: el precio unitario baja, pero el costo de una tarea depende también de cuánto razona el sistema, de las herramientas que usa y de las correcciones necesarias.
El precio reduce dos tarifas, no cada factura
La página oficial de precios permite una comparación precisa. En el tramo estándar hasta 512.000 tokens de entrada, MiniMax M3 cuesta 0,30 dólares por millón en entrada y 1,20 dólares en salida. Flash reduce ambas tarifas a la mitad. La lectura de caché pasa de 0,06 a 0,015 dólares por millón. Son conceptos de facturación distintos: el precio de caché se aplica a los tokens efectivamente reconocidos como reutilizables, no a todo el material enviado.
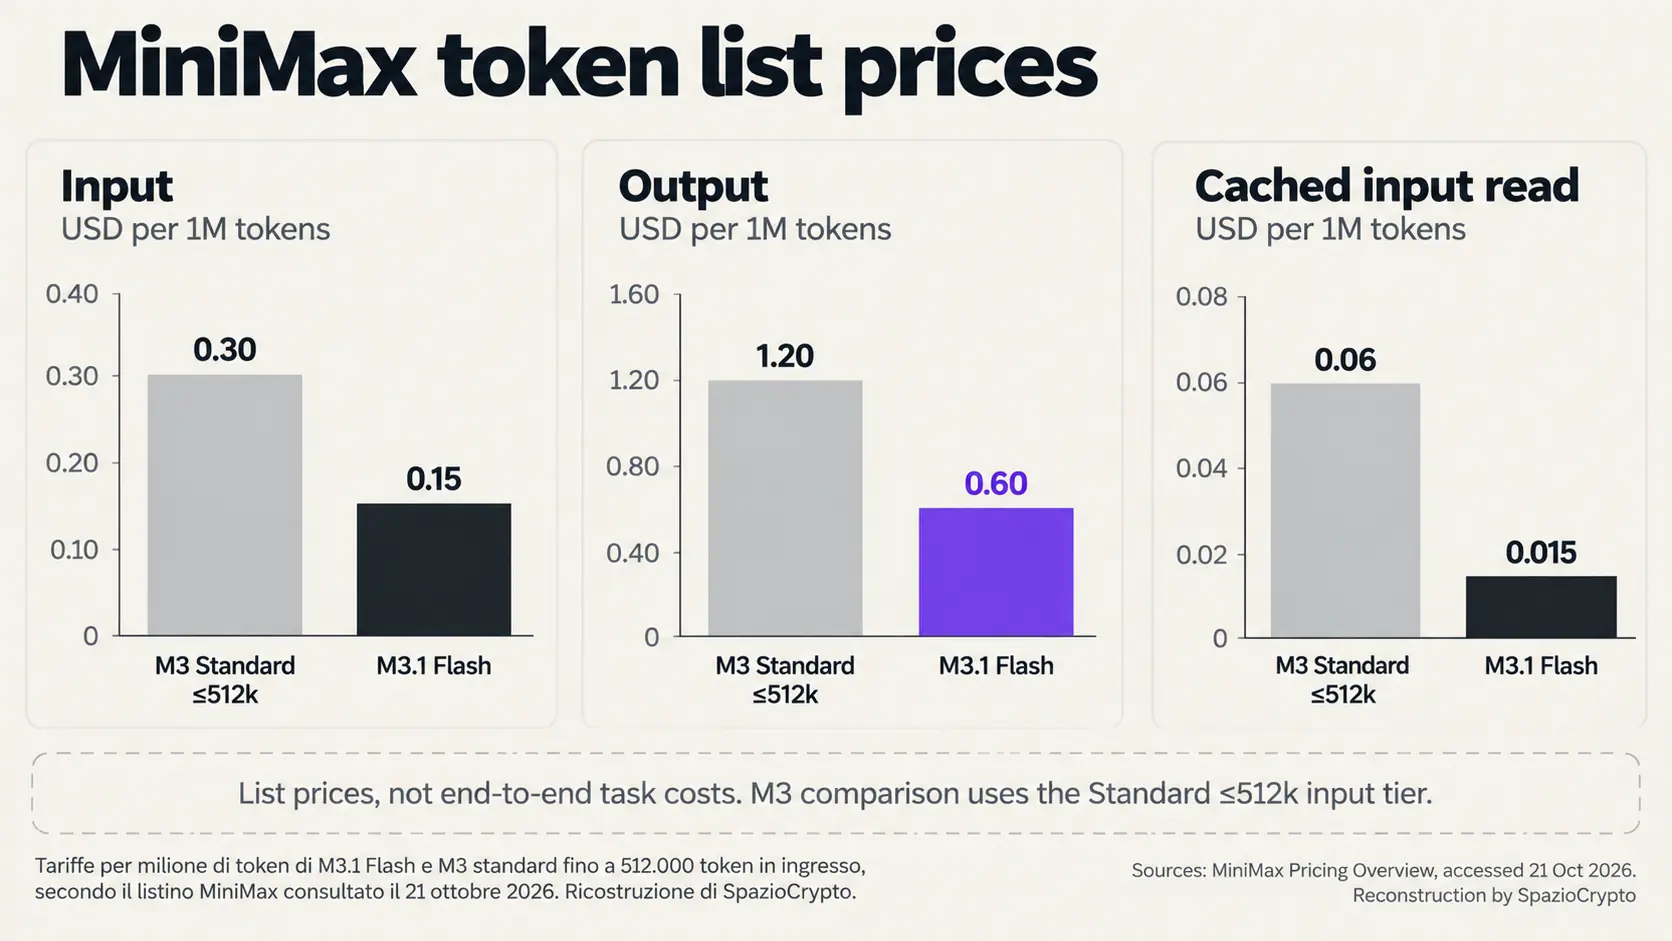
El comunicado oficial menciona un costo total de tareas agénticas inferior al 70% respecto al modelo anterior. Ese dato no coincide con la simple reducción a la mitad de las dos tarifas principales. Puede incluir diferencias en el consumo y en el modo de completar el trabajo, pero no autoriza a prometer ese ahorro a cada cliente. Al evaluar la adopción de sistemas automatizados, esta distinción separa un listado verificable de un resultado operativo que aún debe medirse sobre la carga propia.
Un ejemplo aclara la diferencia. Un millón de tokens de entrada, distribuidos entre solicitudes dentro del tramo indicado, y 100.000 en salida, sin caché, costarían 0,21 dólares con Flash y 0,42 con M3 en el tramo indicado. Es un cálculo propio e indicativo, construido sobre el mismo consumo hipotético. No incluye llamadas adicionales, herramientas ni trabajo humano. Si un agente repite un paso o produce más razonamiento, la cantidad facturada cambia aunque el precio unitario permanezca idéntico.
El razonamiento tiene regulación, no apagado
La documentación de la interfaz compatible con Anthropic describe cinco niveles de razonamiento, de low a max. Para M3.1 Flash, max es el valor predeterminado cuando se omite el parámetro. El razonamiento adaptativo no puede desactivarse con los valores indicados para apagarlo: la documentación señala un error para esa solicitud. Una integración que reutiliza configuraciones anteriores debe, por tanto, verificar el comportamiento efectivamente admitido por el nuevo modelo.
Según las mismas instrucciones, aumentar el nivel puede producir más tokens de razonamiento y mayor latencia. El precio de cada token y el tiempo total de la respuesta describen, entonces, dos aspectos distintos. Una prueba útil debe mantener constantes el objetivo, las herramientas y los criterios de aceptación, anotando el nivel elegido. De lo contrario, se corre el riesgo de comparar una respuesta rápida con un trabajo más exhaustivo sin explicitar el motivo de la diferencia.
MiniMax M3.1 Flash: Space Performance + Bunny Speed 🚀🐰 Yes, Space Bunny - which has topped global leaderboards with 200T+ tokens - was an earlier version of M3.1 Flash. 💰Redefining the performance economics of agentic AI. M3.1 Flash achieves frontier-level intelligence across key tasks such as Cowork (Automation-Bench: 62%; ALE: 30%), Coding (DeepSWE: 74%) and Visual Reasoning (BabyVision: 91%), at 1/3 the cost of M3 and 3x the speed. API pricing (flat rate): $0.15 / $0.60 per 1M input/output tokens, with cache reads at $0.015 / 1M tokens. Model weights will arrive on Oct 23. API: https://t.co/fHRdSV73Hr M Plan: https://t.co/XfJWSyauda MiniMax Code for desktop: https://t.co/SGmLTI2HQm
, MiniMax (official) (@MiniMax_AI) October 19, 2026
El catálogo oficial indica una ventana de contexto de un millón de tokens y capacidades multimodales. La capacidad declarada no garantiza que cada documento extenso se procese correctamente. Para quien integra el modelo a través de una interfaz API, el es conservar la información necesaria entre un paso y el siguiente. Una solicitud muy amplia puede contener instrucciones superfluas o contradictorias: poder aceptarla no demuestra que el modelo sepa seleccionar siempre el material adecuado.
Los benchmarks son pruebas acotadas
MiniMax publica resultados sobre programación, uso del ordenador y seguridad. Entre los mencionados en el comunicado figuran 73,7% en DeepSWE v1.1, 61,7 puntos en OSWorld V2 y 82% en CyberGym. Son resultados presentados por el propio fabricante. El comunicado también indica 76,2 puntos en BankerToolBench y 29,6 en Agents' Last Exam. Las pruebas observan tareas distintas y no pueden sumarse para construir un porcentaje general de fiabilidad. Un buen resultado en problemas de código no demuestra por sí solo que un agente gestione sin errores documentos o permisos financieros.
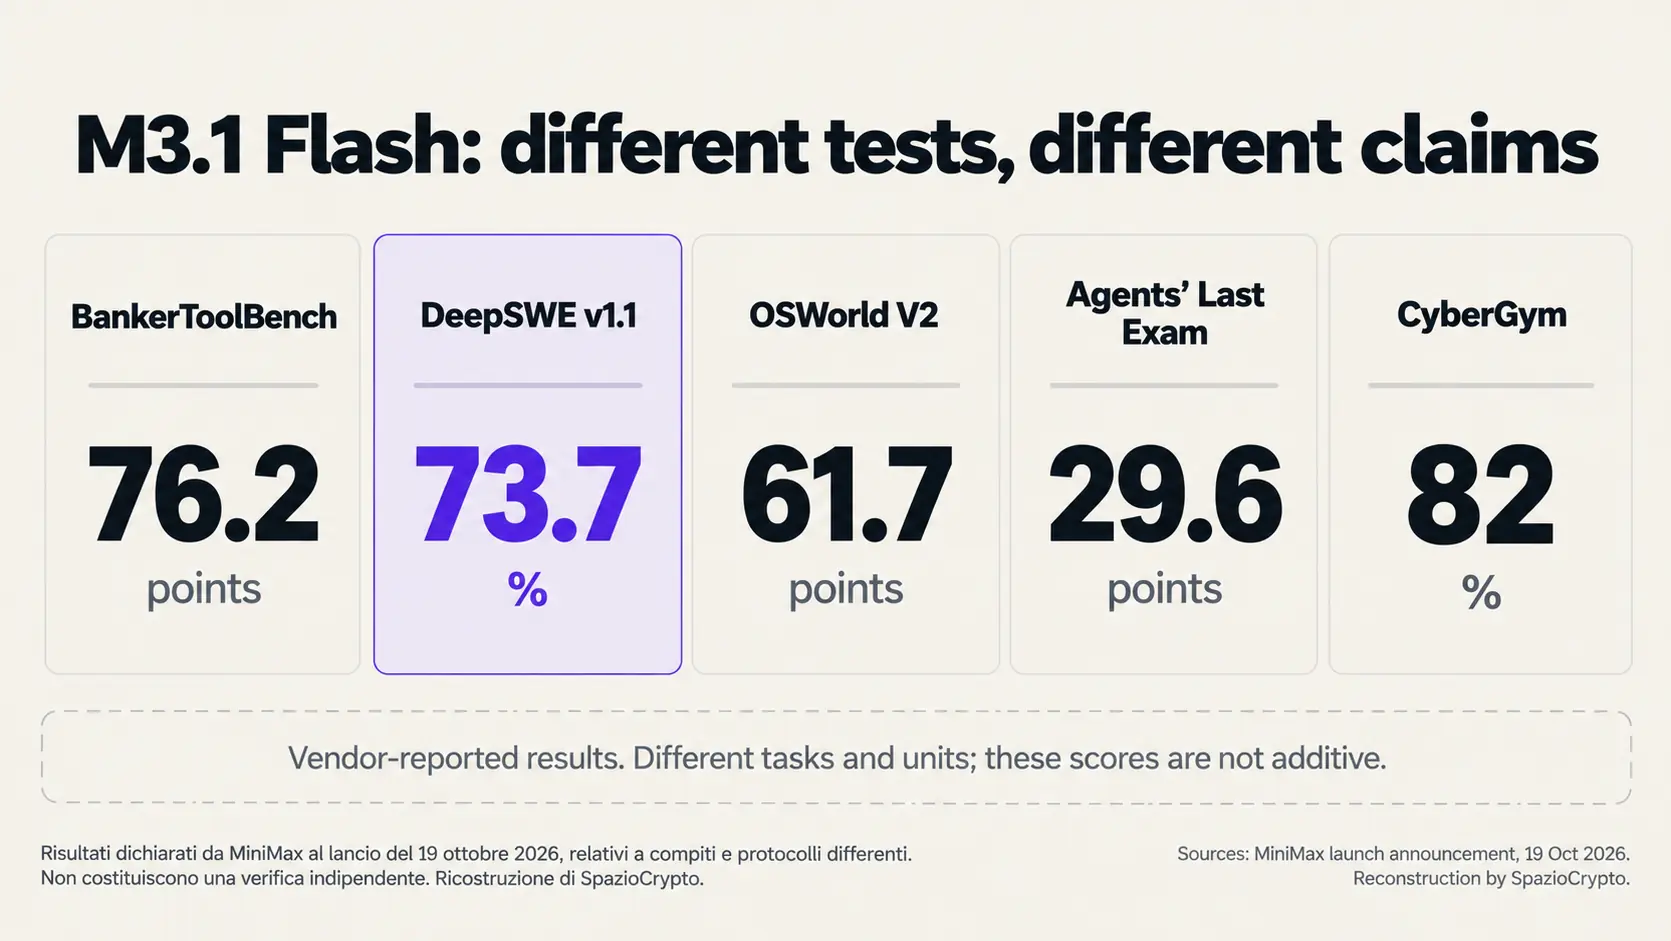
Las velocidades también requieren una etiqueta. La compañía declara más de 200 tokens por segundo en ciertas condiciones y una mediana superior a 170. Son datos de su propia infraestructura, no una garantía sobre el tiempo necesario para completar cada procedimiento. El número de tokens generados por segundo no incluye automáticamente todas las esperas entre una llamada y otra, las respuestas de servicios externos ni la intervención de quien controla el resultado.
La distinción importa también en las comparaciones entre benchmarks de modelos. Un número debe ir acompañado de la versión del test, las herramientas permitidas y la configuración de razonamiento. Para Flash, hacen falta comparaciones con un objetivo idéntico y un presupuesto declarado. Presentar la capacidad de encontrar vulnerabilidades como prueba de fiabilidad general del modelo confundiría la tarea observada con todas las demás actividades que podría realizar.
Artificial Analysis ofrece una valoración externa sobre otra suite: según su publicación dedicada, asigna a Flash 42 puntos en el Intelligence Index, con razonamiento al máximo. Indica aproximadamente 0,22 dólares por tarea del índice frente a unos 0,51 dólares para M3. Es una evaluación publicada por un tercero distinto del fabricante, no una réplica propia. Ese costo corresponde a las tareas y al método de su índice: no es el precio universal de cualquier trabajo encomendado al modelo.
Acceso al servicio y control de pesos son fases distintas
El lanzamiento del 19 de octubre indica tres canales: API MiniMax, M Plan y MiniMax Code. El comunicado remite los pesos a un momento posterior sin fecha concreta; una publicación de la página oficial de MiniMax en LinkedIn señala, en cambio, el 23 de octubre. Es un plazo anunciado, no una publicación ya realizada. El servicio disponible y el artefacto descargable siguen siendo, por tanto, dos fases distintas. La identificación de Space Bunny como versión inicial del modelo es una declaración de MiniMax; el nombre anónimo no constituye una evaluación independiente.
MiniMax-M3.1-Flash scores 42 on the Artificial Analysis Intelligence Index, 13 points higher than MiniMax-M3 and less than half the cost per task. It scores level with GLM-5.3-Flash but behind DeepSeek V4.1 Flash 1017
, Artificial Analysis (@ArtificialAnlys) October 19, 2026
MiniMax-M3.1-Flash is @MiniMax_AI's new Flash reasoning… pic.twitter.com/bEelNegMKP
Las dos modalidades permiten verificaciones distintas. Un servicio alojado permite probar de inmediato la interfaz y el comportamiento de las respuestas. La publicación de los pesos abriría la posibilidad de conservar el artefacto y estudiar otras configuraciones, según la licencia que lo acompañe. El comunicado no es suficiente para describir esa licencia ni el hardware necesario. Hasta la publicación, atribuir a Flash una disponibilidad autónoma ya completa anticiparía un paso todavía prometido.
El cálculo útil es el de la tarea completada
En el paso del coding asistido al agéntico, el costo se distribuye entre varios intentos. Un agente puede leer un repositorio, proponer una modificación, ejecutar pruebas y volver al código cuando un control falla. Es un ejemplo operativo propio, no un resultado medido sobre Flash. La comparación económica debería contar toda la secuencia hasta la aceptación del trabajo, incluidas las ejecuciones que no llegan a una solución utilizable.
El valor de una evaluación independiente depende también de cuánto esas secuencias son observables y reproducibles. La propuesta es registrar resultado, consumo, repeticiones y correcciones, manteniendo idéntico el criterio con el que se acepta el resultado. Reducir el nivel de razonamiento puede disminuir una sola espera y aumentar las revisiones posteriores. Es una hipótesis a verificar sobre la carga elegida, no un comportamiento atribuible al modelo sin haberlo medido.
MiniMax M3.1 Flash
- Confirmado: lanzamiento del 19 de octubre, listado público y documentación del acceso alojado.
- Pendiente de verificación: publicación efectiva de los pesos anunciada en LinkedIn para el 23 de octubre y ahorro real en cada proceso.
- A seguir: consumo en igualdad de tarea, correcciones requeridas y disponibilidad de los artefactos prometidos.
La lectura más amplia
Básicamente, la competencia en la inteligencia artificial aplicada se está desplazando del precio de la respuesta al costo del trabajo aceptable. El listado de Flash rebaja un componente medible; no elimina la necesidad de verificar el resultado. Un modelo económico se vuelve realmente útil cuando reduce también los pasos que requieren correcciones, con igualdad de resultado exigido y de condiciones de ejecución.
Las próximas señales concretas serán el cumplimiento del plazo anunciado para los pesos, comparaciones reproducibles con configuraciones explícitas y mediciones sobre tareas representativas. Conviene observar también qué sucede cuando el sistema no lo logra: si señala el límite, interrumpe el trabajo o continúa gastando. Son diferencias que una tarifa por millón de tokens no puede explicar, pero que determinan el costo final de un agente fiable.